Disusun dengan bantuan AI. Angka dan kutipan dari pihak lain ditautkan ke sumber yang dibuka saat menulis.
Pantulan yang tidak sama dengan aslinya: gambaran sederhana jawaban AI yang terlihat benar tetapi bergeser dari sumbernya. Ilustrasi: Nalurika
Halusinasi AI adalah kondisi ketika AI menghasilkan jawaban yang terdengar yakin tetapi salah, tidak berdasar, atau dikarang, misalnya sumber yang tidak pernah ada, angka tanpa asal, atau kebijakan perusahaan yang tidak pernah dibuat. Halusinasi terjadi karena model bahasa dilatih menebak kata berikutnya, bukan memeriksa fakta. Risikonya bisa diturunkan dengan memberi sumber rujukan, mengizinkan AI menjawab "tidak tahu", dan mewajibkan pemeriksaan manusia di titik berisiko.
Hampir semua orang yang rutin memakai ChatGPT, Gemini, atau Claude pernah mengalaminya. Anda meminta referensi, AI memberi judul jurnal yang rapi lengkap dengan tahun dan penulis, lalu ternyata jurnal itu tidak ada. Di obrolan pribadi, kesalahan seperti ini cuma bikin kesal. Di bisnis, kesalahan yang sama bisa berubah menjadi janji palsu ke pelanggan, laporan yang salah angka, atau dokumen hukum yang memalukan.
Artikel ini menjelaskan apa itu halusinasi AI, kenapa terjadi, contoh kasus nyata yang sampai ke pengadilan, dan kebiasaan kerja yang kami sarankan agar tim tetap bisa memakai AI tanpa termakan jawaban karangan. Untuk dasar cara kerja model, Anda bisa membaca dulu cara kerja AI dan pengertian LLM.
Apa itu halusinasi AI?
Jawaban singkat: halusinasi AI adalah keluaran AI yang salah atau menyesatkan tetapi disajikan seolah benar. Istilah bahasa Inggrisnya AI hallucination.
Google Cloud mendefinisikan AI hallucinations sebagai hasil yang keliru atau menyesatkan yang dihasilkan model AI. Ciri khasnya bukan sekadar salah, tetapi salah dengan percaya diri. Model tidak memberi tanda ragu. Kalimatnya lancar, strukturnya rapi, dan kadang dilengkapi detail spesifik yang justru membuatnya tampak lebih meyakinkan.
Penting dipahami bahwa AI tidak "berbohong" dalam arti sengaja menipu. Model tidak punya niat. Ia menyusun kata yang secara statistik paling mungkin muncul berikutnya. Ketika pola yang paling mungkin itu kebetulan tidak sesuai fakta, hasilnya adalah halusinasi. Karena itu, cara mengatasinya bukan "menegur" AI, melainkan merancang cara kerja yang membuat kesalahan cepat ketahuan.
Halusinasi juga bukan masalah satu merek. Semua model bahasa besar bisa mengalaminya, dengan frekuensi yang berbeda-beda tergantung model, jenis pertanyaan, dan ada tidaknya sumber rujukan. Model yang lebih baru umumnya lebih jarang mengarang, tetapi belum ada yang bebas sepenuhnya.
Kenapa AI bisa mengarang jawaban?
Jawaban singkat: karena model dilatih menebak kata berikutnya, data latihnya tidak sempurna, dan sering tidak diberi sumber rujukan saat menjawab.
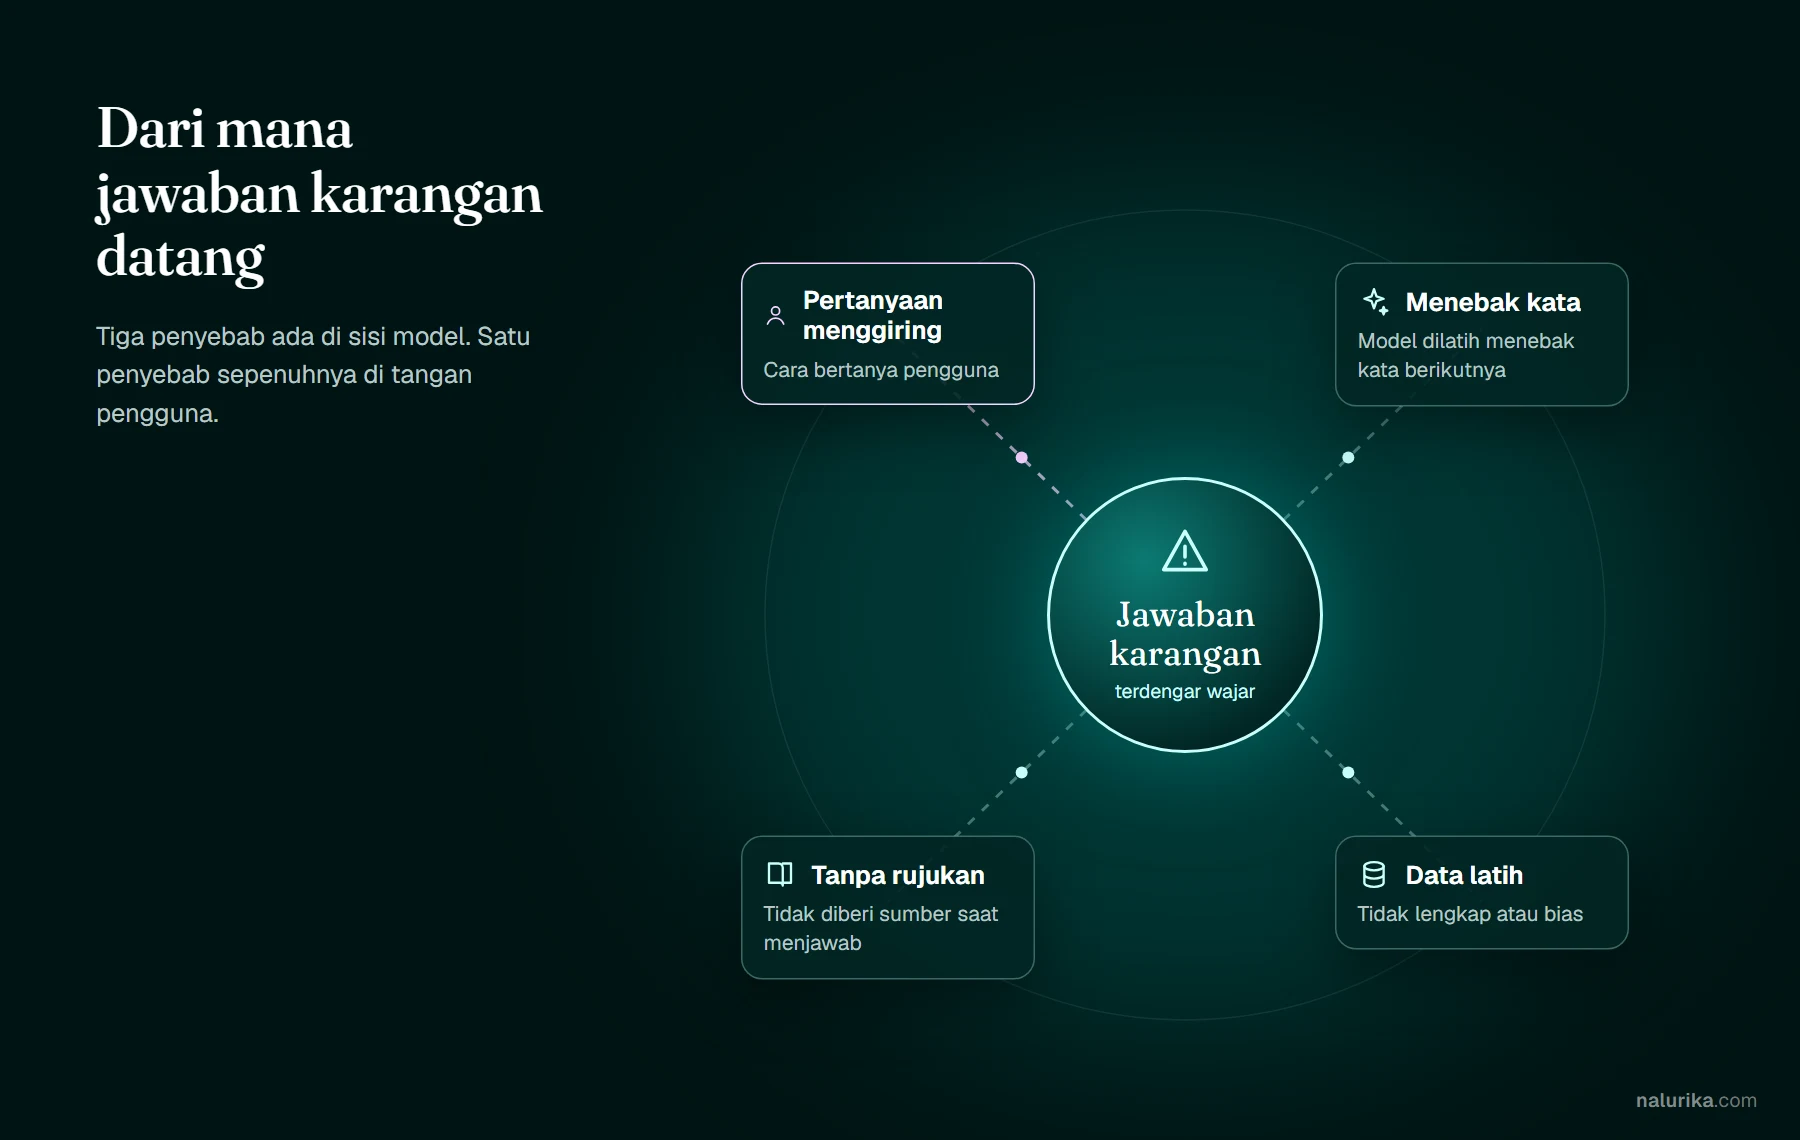
Ringkasan penyebab di Wikipedia tentang AI hallucination menyebut bahwa pelatihan awal model GPT berupa menebak kata berikutnya, sehingga model terdorong "memberi tebakan" walau tidak punya informasinya. Data latih yang tidak lengkap, tidak akurat, atau tidak representatif juga menjadi sumber masalah, termasuk kecenderungan mengulang miskonsepsi umum.
Empat penyebab yang paling sering muncul saat kami menguji AI untuk pekerjaan bisnis. Penyebab yang ditandai pink sepenuhnya ada di tangan pengguna. Diagram: Nalurika
Google Cloud menambahkan faktor kurangnya grounding: model kesulitan memahami pengetahuan dunia nyata atau informasi faktual, sehingga menghasilkan jawaban yang tampak masuk akal tetapi salah. Contoh yang mereka sebut cukup dekat dengan pekerjaan kantor, yaitu ringkasan artikel berita yang memuat detail yang tidak ada di artikel aslinya, bahkan tautan ke halaman yang tidak pernah ada.
Ada satu penyebab lagi yang sering terlupa: cara bertanya. Pertanyaan seperti "jelaskan kenapa kebijakan refund kami 30 hari" mengandaikan bahwa kebijakannya memang 30 hari. Model cenderung mengikuti asumsi itu. Wikipedia juga mencatat bahwa melatih chatbot agar lebih ramah cenderung menurunkan akurasi karena model lebih mudah setuju dengan pengguna. Jadi pertanyaan yang menggiring adalah undangan terbuka untuk halusinasi.
Bentuk halusinasi AI yang sering lolos di kantor
Jawaban singkat: sumber palsu, angka karangan, kebijakan karangan, ringkasan yang menambah isi, dan kutipan yang tidak pernah diucapkan.
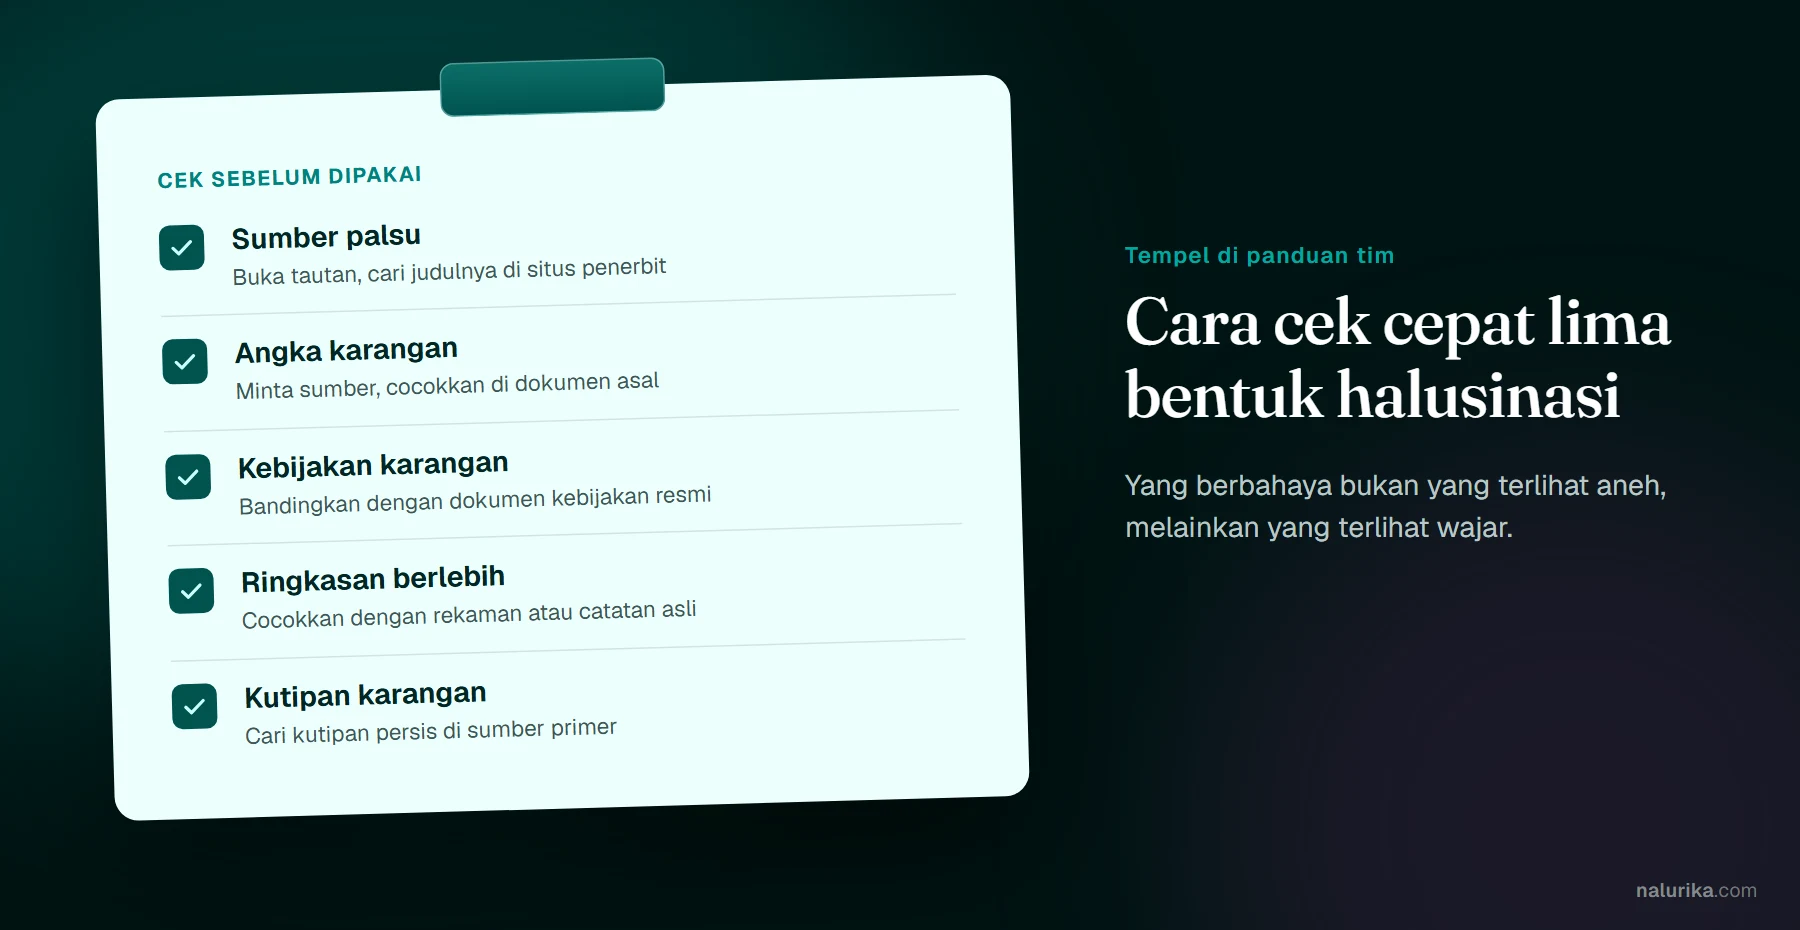
Halusinasi yang berbahaya biasanya bukan yang terlihat aneh, melainkan yang terlihat wajar. Berikut bentuk yang paling sering kami temui saat mendampingi tim memakai AI, beserta cara cek cepatnya:
Bentuk halusinasi AI, contoh di lingkungan kerja, dan cara mengeceknya
Bentuk
Contoh di kantor
Cara cek cepat
Risiko bila lolos
Sumber palsu
Judul jurnal, putusan, atau tautan yang tidak ada
Buka tautan, cari judulnya di situs penerbit
Kredibilitas laporan atau dokumen hilang
Angka karangan
Persentase pasar atau statistik tanpa asal
Minta sumber, cocokkan angka di dokumen asal
Keputusan bisnis berdasar data palsu
Kebijakan karangan
Chatbot menjanjikan refund yang tidak ada di SOP
Bandingkan dengan dokumen kebijakan resmi
Kewajiban memenuhi janji ke pelanggan
Ringkasan berlebih
Notulen memuat keputusan yang tidak dibuat
Cocokkan dengan rekaman atau catatan asli
Tim menjalankan hal yang tidak disepakati
Kutipan karangan
Kalimat tokoh yang tidak pernah diucapkan
Cari kutipan persis di sumber primer
Masalah reputasi dan hukum
Versi ringkas tabel di atas yang bisa ditempel di dokumen panduan tim. Diagram: Nalurika
Untuk pekerjaan seperti notulen rapat dengan AI atau merangkum PDF, bentuk "ringkasan berlebih" adalah yang paling licin. Ringkasannya enak dibaca, tetapi satu keputusan yang tidak pernah dibuat bisa menyelinap masuk dan kemudian dijalankan orang.
Contoh kasus halusinasi AI yang berdampak nyata
Jawaban singkat: kasus pengadilan Mata v. Avianca (2023) dan Moffatt v. Air Canada (2024) menunjukkan bahwa jawaban AI yang dikarang bisa berujung denda dan ganti rugi.
Mata v. Avianca, Amerika Serikat. Dalam perkara cedera penumpang melawan maskapai Avianca, pengacara penggugat menyerahkan dokumen yang memuat kutipan putusan pengadilan buatan ChatGPT. Putusan-putusan itu tidak pernah ada. Menurut ringkasan kasus di Wikipedia, Hakim P. Kevin Castel menolak gugatan dan memerintahkan para pengacara membayar denda 5.000 dolar AS, serta menyebut salah satu analisis hukumnya sebagai "gibberish".
Moffatt v. Air Canada, Kanada. Pada Februari 2024, Civil Resolution Tribunal memerintahkan Air Canada membayar ganti rugi dan menghormati kebijakan tarif duka yang dikarang chatbot layanan pelanggannya. Chatbot menyatakan pelanggan bisa mengajukan potongan tarif duka secara surut, padahal kebijakan sebenarnya tidak mengizinkan itu setelah tiket dipesan. Tribunal juga menolak pembelaan bahwa chatbot adalah entitas hukum terpisah yang bertanggung jawab atas tindakannya sendiri.
Pelajaran dari kasus kedua sangat relevan bagi bisnis yang memasang chatbot WhatsApp atau customer service AI. Apa pun yang diucapkan chatbot ke pelanggan akan dibaca pelanggan sebagai ucapan perusahaan. Kalau chatbot mengarang kebijakan, perusahaanlah yang menanggung akibatnya.
Cara mengatasi halusinasi AI di pekerjaan sehari-hari
Jawaban singkat: beri sumber rujukan, tulis prompt yang tidak menggiring, izinkan AI menjawab tidak tahu, minta sumber untuk setiap klaim, dan periksa klaim berisiko sebelum dipakai.
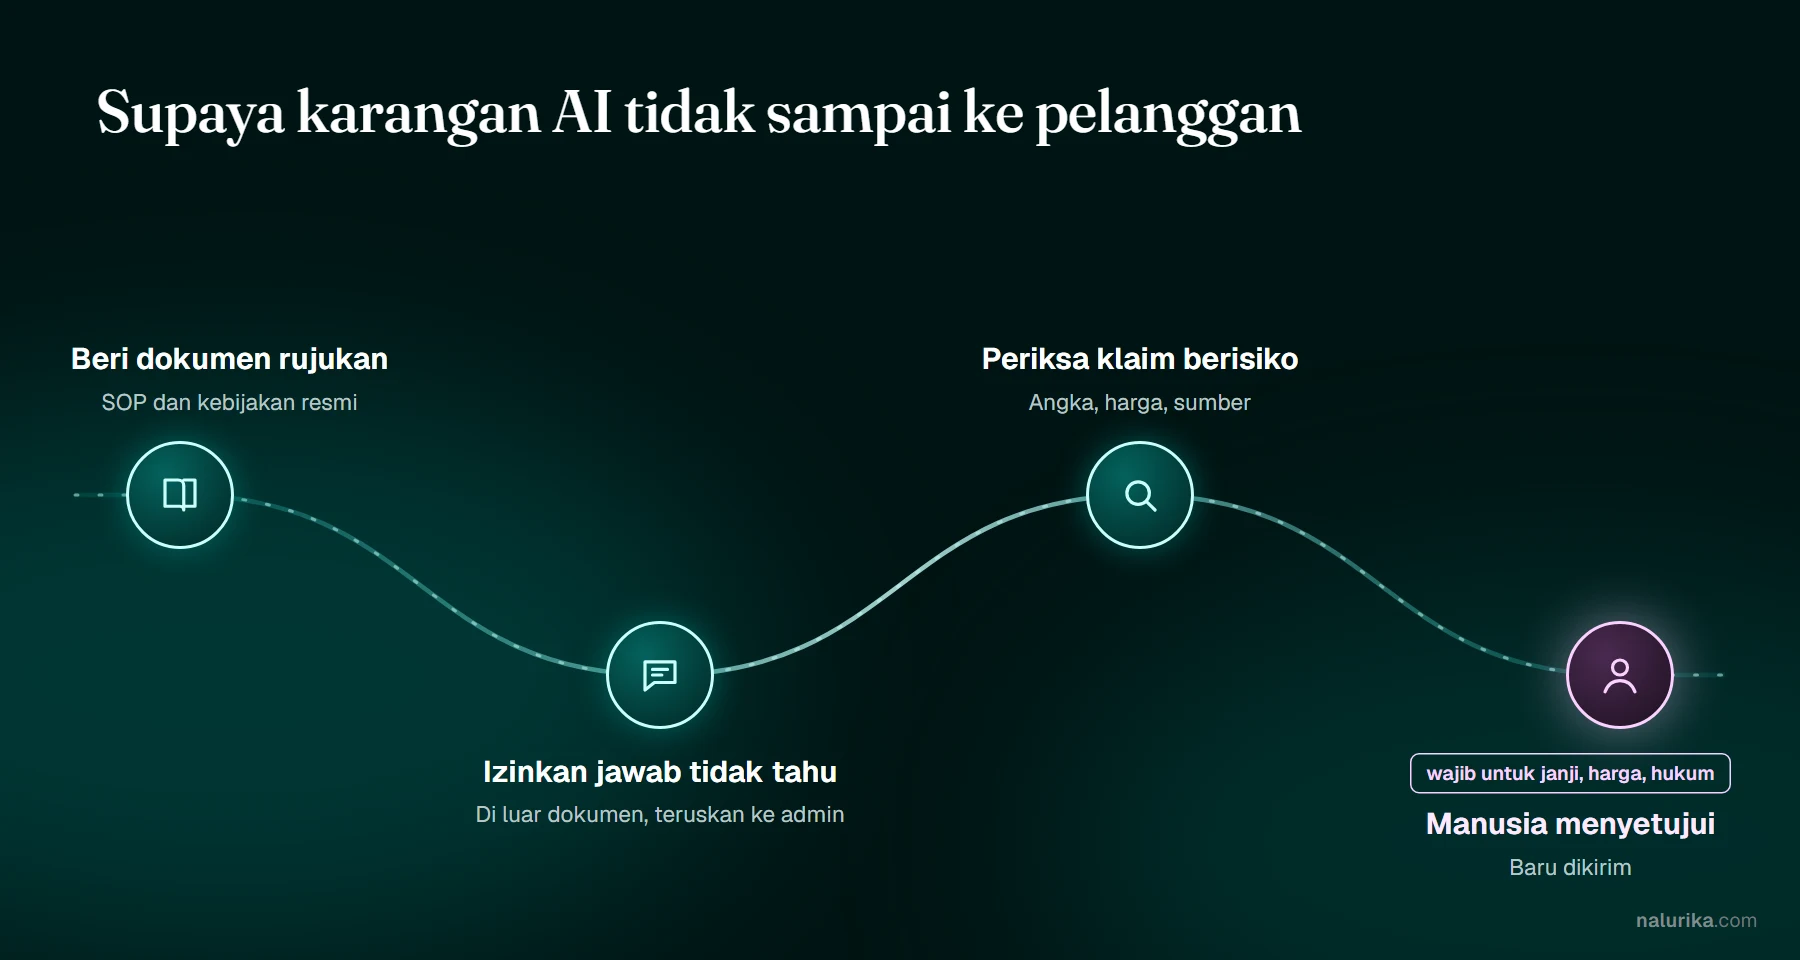
Beri dokumen, jangan andalkan ingatan model. Tempel SOP, katalog, atau kebijakan resmi ke percakapan, atau gunakan sistem berbasis RAG yang mencari di dokumen perusahaan. Pastikan versi dokumennya yang terbaru.
Izinkan jawaban "tidak tahu". Tambahkan instruksi seperti "Jika jawabannya tidak ada di dokumen, katakan tidak ditemukan." Tanpa izin ini, model cenderung tetap menjawab.
Minta sumber untuk setiap klaim. Minta AI menunjukkan bagian dokumen atau tautan yang mendasari tiap angka dan pernyataan, lalu cek sendiri bahwa sumbernya memang memuat hal itu.
Hindari pertanyaan yang menggiring. Tanyakan "berapa lama batas refund menurut SOP ini?" alih-alih "jelaskan kenapa batas refund kita 30 hari."
Pecah tugas besar. Satu permintaan raksasa memperbesar peluang AI mengisi kekosongan. Tugas yang lebih kecil lebih mudah diperiksa.
Periksa klaim berisiko. Angka, harga, nama, tanggal, janji ke pelanggan, dan apa pun yang menyangkut hukum atau keuangan wajib dicocokkan ke sumber sebelum dipakai.
Teknik menulis instruksi yang lebih rinci kami bahas di prompt engineering. Satu hal yang perlu ditegaskan: prompt yang bagus menurunkan frekuensi halusinasi, tetapi tidak menggantikan pemeriksaan untuk keputusan yang berisiko.
Contoh instruksi yang bisa langsung dipakai tim customer service: "Jawab hanya berdasarkan dokumen kebijakan di bawah. Kutip kalimat dokumen yang menjadi dasar jawaban. Jika pertanyaan tidak tercakup, tulis: informasi ini perlu dicek admin." Tiga kalimat ini mengubah perilaku model cukup banyak, karena model diberi sumber, diminta menunjukkan dasar, dan diberi jalan keluar yang jujur ketika jawabannya tidak ada.
Membangun alur kerja yang tahan halusinasi
Jawaban singkat: perlakukan AI sebagai penyusun draf, bukan otoritas, dan pasang titik persetujuan manusia sebelum hasilnya sampai ke pelanggan atau keputusan penting.
IBM menulis bahwa tata kelola AI dimulai dengan mengakui halusinasi sebagai sifat bawaan model generatif, sehingga kontrol harus dirancang dengan asumsi keluaran bisa salah. Mereka menyarankan organisasi menentukan keluaran AI mana yang wajib ditinjau dan disetujui manusia, misalnya nasihat hukum dan dokumen regulasi, lalu menanamkan langkah tinjauan itu langsung ke alur kerja. Pendekatan ini mendorong tim memperlakukan AI sebagai asisten penyusun draf dan riset, bukan sebagai otoritas.
Alur kerja yang kami pakai saat memasang AI di proses yang menyentuh pelanggan. Langkah keempat tidak pernah dilewati untuk janji, harga, dan hal hukum. Diagram: Nalurika
Dalam praktik, kami biasanya membagi keluaran AI menjadi tiga tingkat. Tingkat rendah, seperti ide judul atau draf internal, cukup dibaca sekilas. Tingkat menengah, seperti ringkasan rapat atau laporan internal, dicek terhadap sumber aslinya. Tingkat tinggi, seperti jawaban ke pelanggan tentang harga, refund, kontrak, atau data pribadi, selalu melewati persetujuan orang yang berwenang. Pembagian tingkat ini bisa langsung dimasukkan ke SOP tim.
Jika Anda memakai otomasi, misalnya auto reply atau agen AI yang tersambung ke CRM, rancang agar pertanyaan di luar cakupan dokumen diteruskan ke admin, bukan dijawab dengan tebakan. Prinsip ini juga bagian dari etika penggunaan AI di tempat kerja.
Kebiasaan tim yang membuat halusinasi cepat ketahuan
Jawaban singkat: catat kasus halusinasi yang ditemukan, bagikan contohnya ke tim, dan ubah temuan itu menjadi aturan cek yang tertulis.
Tim yang paling aman memakai AI biasanya bukan tim yang paling jarang menemukan halusinasi, tetapi tim yang paling cepat menemukannya. Mereka punya kebiasaan kecil: setiap kali ada jawaban AI yang ternyata salah, contohnya dicatat di satu dokumen bersama, lengkap dengan pertanyaan aslinya dan apa yang salah. Dari catatan itu muncul pola, misalnya AI sering keliru soal tanggal promo atau ongkos kirim. Pola itu lalu menjadi aturan cek yang tertulis.
Kebiasaan lain yang membantu adalah membiasakan kalimat "sumbernya mana?" di setiap rapat yang memakai bahan dari AI. Kalimat ini sederhana, tetapi menggeser budaya dari percaya buta ke verifikasi. IBM menyebut hal serupa: alat tata kelola dapat melatih karyawan memperlakukan keluaran AI sebagai draf yang harus dicek, mencegah budaya "cukup bagus" yang membiarkan halusinasi lolos.
Terakhir, ajari tim membedakan pekerjaan yang cocok untuk AI dan yang tidak. AI sangat membantu untuk menyusun draf, merapikan bahasa, merangkum dokumen yang Anda berikan, dan menyusun kerangka. AI berisiko tinggi untuk mencari fakta baru tanpa sumber, memberi angka pasar, atau menjawab pertanyaan hukum. Kemampuan membedakan dua kelompok ini adalah salah satu materi inti saat kami mengajar tim memakai AI.
Kesimpulan
Halusinasi AI adalah jawaban yang salah tetapi disampaikan dengan yakin, dan sampai sekarang belum ada model yang bebas darinya. Penyebabnya ada pada cara model bekerja, kualitas data latih, tidak adanya sumber rujukan, dan cara kita bertanya. Kasus Mata v. Avianca dan Moffatt v. Air Canada menunjukkan bahwa akibatnya bisa nyata dan mahal. Kabar baiknya, risiko ini bisa dikendalikan dengan kebiasaan sederhana: beri sumber, izinkan jawaban tidak tahu, cek klaim berisiko, dan pasang persetujuan manusia di titik penting.
Kalau tim Anda ingin memakai AI dengan kebiasaan cek yang rapi, materi seperti ini kami ajarkan di kursus AI untuk tim bisnis, lengkap dengan latihan menemukan halusinasi pada contoh pekerjaan nyata.
Halusinasi AI adalah jawaban AI yang salah, tidak berdasar, atau dikarang, tetapi disampaikan seolah-olah benar. Contohnya sumber yang tidak pernah ada, angka tanpa asal, atau kebijakan perusahaan yang tidak pernah dibuat.
Model bahasa dilatih untuk menebak kata berikutnya, sehingga terdorong memberi jawaban walau informasinya tidak tersedia. Data latih yang tidak lengkap atau bias, serta tidak adanya sumber rujukan, ikut memperbesar risikonya.
Belum. Penyedia seperti IBM menyebut halusinasi sebagai sifat bawaan model generatif, sehingga kontrol harus dirancang dengan asumsi jawaban bisa salah. Yang bisa dilakukan adalah menurunkan frekuensinya dan mencegahnya lolos ke keputusan penting.
Dalam kasus Mata v. Avianca di Amerika Serikat tahun 2023, pengacara menyerahkan kutipan putusan palsu buatan ChatGPT dan didenda 5.000 dolar AS. Pada 2024, Air Canada diperintahkan membayar ganti rugi karena chatbot-nya mengarang kebijakan tarif duka.
RAG mengurangi ketergantungan pada ingatan model dengan memberi dokumen rujukan, tetapi tidak menghapus halusinasi. Jawaban tetap bisa salah bila dokumennya keliru, pencariannya mengambil bagian yang salah, atau pertanyaannya di luar cakupan sumber.
Buka setiap tautan yang diberikan, cari judul sumber di situs aslinya, cocokkan angka dengan dokumen asal, dan bandingkan janji atau kebijakan dengan SOP resmi. Klaim yang tidak bisa dicek sebaiknya tidak dipakai.
Dalam kasus Moffatt v. Air Canada, tribunal menolak argumen bahwa chatbot adalah entitas terpisah yang bertanggung jawab atas tindakannya sendiri. Pelajaran praktisnya, perusahaan perlu memperlakukan jawaban chatbot sebagai pernyataan perusahaan.
Bisa membantu. Beri konteks dan dokumen, izinkan AI menjawab tidak tahu, minta sumber untuk setiap klaim, dan hindari pertanyaan yang mengandaikan sesuatu sudah benar. Namun prompt tidak menggantikan pemeriksaan manusia untuk keputusan berisiko.