Disusun dengan bantuan AI. Angka dan kutipan dari pihak lain ditautkan ke sumber yang dibuka saat menulis.
Teks yang masuk dipecah jadi potongan kecil, diolah lapis demi lapis, lalu disusun kembali menjadi jawaban. Ilustrasi: Nalurika
LLM adalah singkatan dari large language model, model kecerdasan buatan yang dilatih dari teks dalam jumlah sangat besar sehingga mampu memahami perintah dalam bahasa sehari-hari dan menyusun jawaban dalam bahasa yang sama. Model inilah mesin di balik ChatGPT, Claude, Gemini, dan Copilot. Model tidak mencari jawaban di dalam dokumen, melainkan menyusunnya potongan demi potongan.
Istilah LLM biasanya muncul di rapat setelah seseorang memakai AI untuk menulis draf lalu bertanya kenapa hasilnya kadang tepat dan kadang mengarang. Jawabannya ada di cara kerja model ini, dan cara kerjanya cukup sederhana untuk dijelaskan tanpa matematika.
Artikel ini membahas pengertian LLM menurut sumber resmi, bagaimana jawabannya disusun, istilah yang perlu dimengerti saat memilih alat, batas bawaan yang tidak akan hilang di versi berikutnya, serta cara membuat model mengenal data perusahaan Anda. Penjelasan yang lebih umum tentang kecerdasan buatan ada di artikel cara kerja AI.
Pengertian large language model
IBM mendefinisikan large language model sebagai kategori model dasar yang dilatih dengan sejumlah besar data sehingga mampu memahami dan menghasilkan bahasa alami serta jenis isi lainnya (IBM). NVIDIA menjelaskannya sebagai algoritma pembelajaran mendalam yang bisa mengenali, meringkas, menerjemahkan, memprediksi, dan menghasilkan teks (NVIDIA). Wikipedia mencatat bahwa model bahasa besar modern dibangun di atas arsitektur bernama transformer, yang diperkenalkan pada 2017 (Wikipedia).
Kata besar di sini menunjuk dua hal sekaligus. Pertama, jumlah teks yang dipakai melatihnya, yang biasanya mencakup sebagian besar teks publik di internet, buku, dan kode program. Kedua, jumlah parameter di dalam modelnya, yaitu angka-angka hasil pelatihan yang menentukan bagaimana model merespons. Parameter inilah yang disebut orang saat menyebut model berukuran 4B atau 70B.
LLM, model, dan aplikasi itu tiga hal berbeda
Kekacauan istilah paling sering terjadi di sini. LLM adalah jenis teknologinya. Model adalah satu produk konkret dari jenis itu, lengkap dengan nama dan versi. Aplikasi adalah tempat Anda mengetik, yang di belakangnya memanggil satu atau beberapa model. Satu aplikasi bisa berganti model tanpa mengubah tampilannya, dan itu sebabnya hasil yang Anda dapatkan bisa terasa berubah walau Anda tidak mengubah apa pun. Untuk membandingkan aplikasinya, lihat daftar di artikel aplikasi AI.
Cara kerja LLM saat menjawab
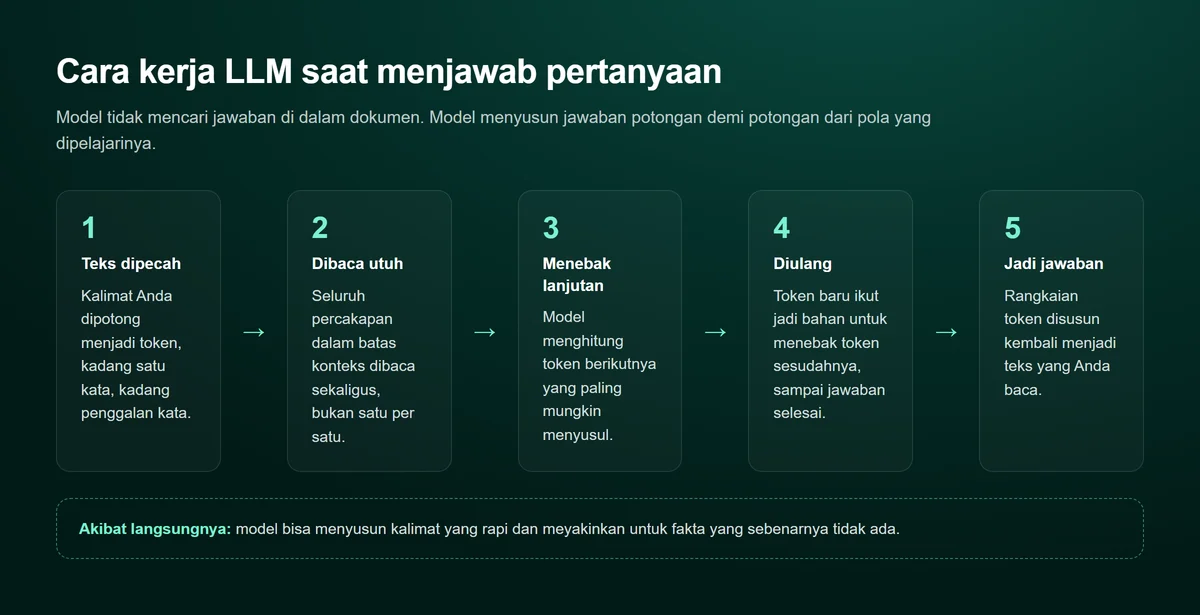
Model menyusun jawaban satu potongan demi satu potongan. Tidak ada tahap memeriksa kebenaran di dalam proses ini. Diagram: Nalurika
Secara ringkas, model menerima teks Anda, memecahnya menjadi potongan kecil, lalu menghitung potongan apa yang paling mungkin menyusul. Potongan baru itu ditambahkan ke rangkaian, dan prosesnya diulang sampai jawabannya selesai. Tidak ada langkah pencarian di basis data, dan tidak ada langkah verifikasi fakta kecuali aplikasinya sengaja menambahkannya.
Token, satuan yang menentukan batas dan biaya
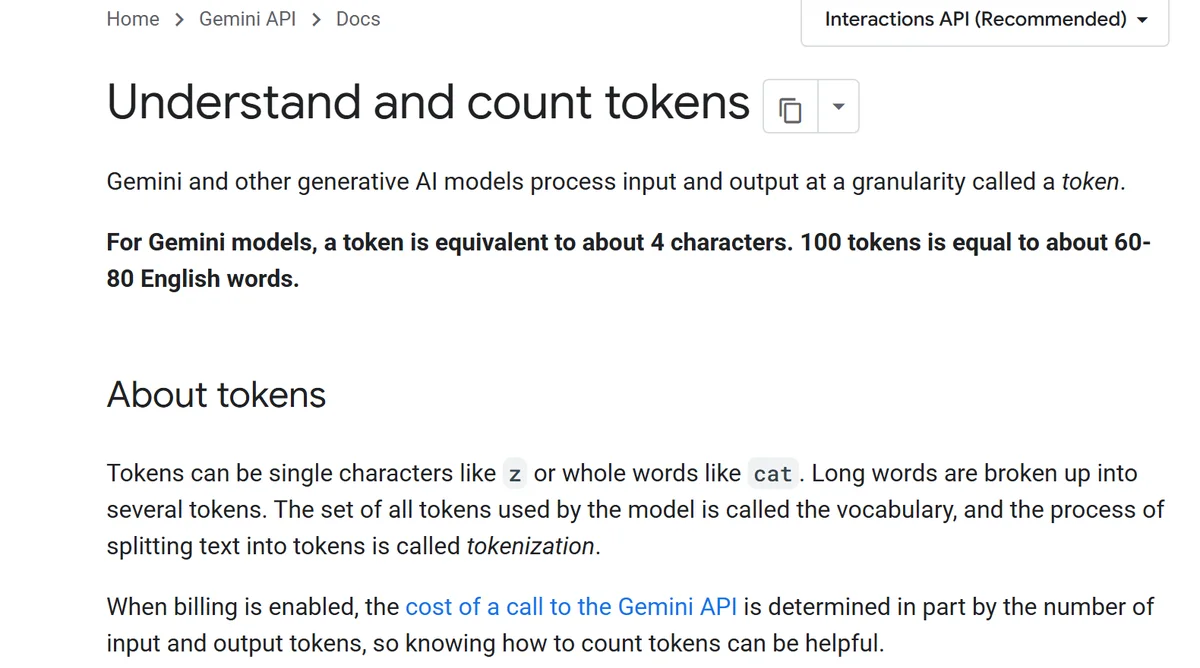
Dokumentasi Gemini API menjelaskan bahwa model memproses masukan dan keluaran pada tingkat kerincian yang disebut token, dan untuk model Gemini satu token setara sekitar empat karakter, sementara 100 token kira-kira setara 60 sampai 80 kata bahasa Inggris (Google AI for Developers). Token bisa berupa satu karakter, bisa juga satu kata utuh, dan kata panjang dipecah menjadi beberapa token.
Angka token dari dokumentasi resmi Gemini API. Karena penagihan API dihitung per token, perkiraan ini juga jadi dasar menghitung biaya. Tangkapan layar: Nalurika dari Google AI for Developers (ai.google.dev), 23 Oktober 2026
Dua akibat praktisnya untuk pemilik usaha. Pertama, ada batas berapa banyak teks yang bisa dibaca model dalam satu percakapan, yang disebut jendela konteks. Kedua, pemakaian lewat API ditagih berdasarkan jumlah token masuk dan keluar, sehingga perintah yang bertele-tele dan dokumen yang ditempel berulang kali benar-benar menambah biaya.
Dari mana model belajar
Pelatihan model bahasa besar berlangsung dalam dua tahap besar. Tahap pertama disebut pralatihan: model dibiarkan membaca teks dalam jumlah sangat besar dan belajar menebak kelanjutan kalimat. Di tahap ini model belum tahu cara bersikap, dia hanya menyerap pola bahasa, fakta umum, dan cara menyusun argumen. Tahap ini yang paling mahal dan paling lama, dan hanya dikerjakan perusahaan yang punya perangkat keras besar.
Tahap kedua adalah penyetelan. Model diajari mengikuti perintah, menjawab dengan sopan, dan menolak permintaan tertentu. Di sinilah perbedaan karakter antarmodel terbentuk, dan juga alasan kenapa dua model yang kemampuan dasarnya mirip bisa terasa sangat berbeda saat dipakai. Wikipedia mencatat bahwa model modern dibangun di atas arsitektur transformer yang diperkenalkan pada 2017, dan arsitektur inilah yang membuat pelatihan dalam skala sebesar itu mungkin dilakukan (Wikipedia).
Satu hal yang perlu dipegang pemilik usaha: proses belajar ini berhenti pada satu titik waktu. Apa pun yang terjadi setelah titik itu tidak diketahui model, kecuali aplikasinya diberi kemampuan mencari di internet atau diberi dokumen secara langsung. Jadi ketika model menjawab pertanyaan tentang aturan atau harga terbaru dengan nada yakin, jawaban itu justru yang paling perlu diperiksa.
Istilah yang sering muncul saat memilih alat
Istilah yang paling sering muncul di dokumentasi dan penawaran vendor, beserta artinya dalam bahasa sehari-hari.
Istilah
Artinya
Kenapa penting untuk usaha
Token
Potongan teks terkecil yang diproses model
Dasar perhitungan biaya dan batas panjang percakapan
Jendela konteks
Batas teks yang bisa dibaca sekaligus dalam satu percakapan
Menentukan sepanjang apa dokumen yang bisa dianalisis sekali jalan
Parameter
Jumlah angka hasil pelatihan di dalam model
Model besar biasanya lebih mampu tetapi lebih lambat dan lebih mahal
Prompt
Perintah atau pertanyaan yang Anda tulis
Kualitas hasil sangat bergantung pada kejelasan perintah
Halusinasi
Jawaban yang terdengar yakin tetapi salah
Alasan utama semua keluaran tetap diperlakukan sebagai draf
RAG
Pola yang membuat model mengambil bahan dari sumber tepercaya sebelum menjawab
Cara paling umum membuat model mengenal dokumen perusahaan
Berapa banyak model yang sebenarnya ada
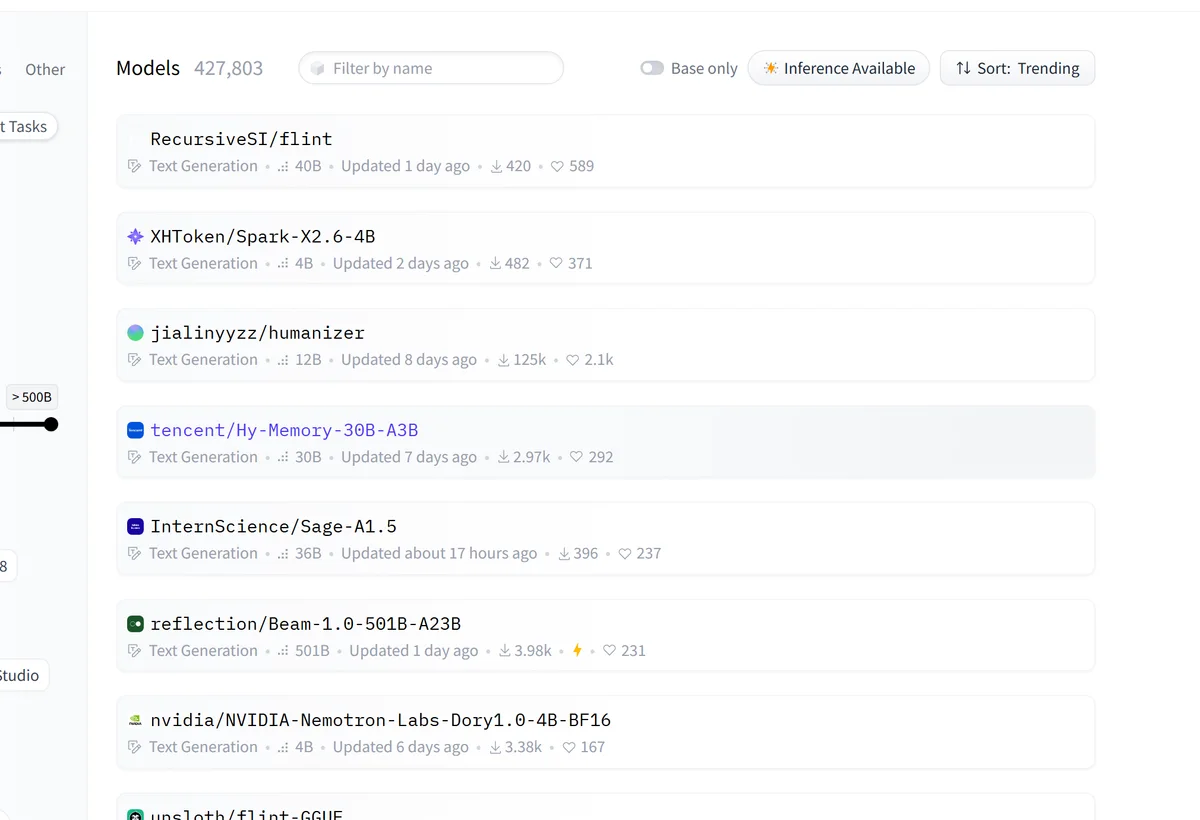
Jumlah model jauh lebih banyak daripada nama merek yang terdengar di berita. Katalog publik Hugging Face mencatat lebih dari 427 ribu model untuk tugas menghasilkan teks saja, dengan ukuran yang terentang dari di bawah satu miliar parameter sampai di atas 500 miliar.
Katalog Hugging Face per 23 Oktober 2026. Angka seperti 4B dan 501B di tiap baris adalah jumlah parameter model itu. Tangkapan layar: Nalurika dari Hugging Face (huggingface.co), 23 Oktober 2026
Model terbuka dan model tertutup
Katalog sebesar itu berisi dua jenis yang berbeda cara pakainya. Model tertutup hanya bisa diakses lewat layanan pembuatnya, biasanya dengan penagihan per token, dan isinya tidak bisa diunduh. Model terbuka bisa diunduh dan dijalankan di komputer atau server sendiri, sehingga datanya tidak pernah keluar dari tempat Anda. Harganya bukan nol, karena pindah ke perangkat keras sendiri berarti menanggung biaya server dan orang yang merawatnya.
Untuk pekerjaan kantor sehari-hari, jumlah ini sebenarnya tidak relevan. Yang relevan hanya satu pertanyaan: apakah aplikasi yang dipakai tim Anda memberi hasil yang cukup baik untuk pekerjaan Anda, dengan ketentuan data yang bisa Anda terima. Model terbuka yang bisa dijalankan di server sendiri baru masuk akal kalau ada alasan kuat soal kerahasiaan data atau biaya pada volume besar.
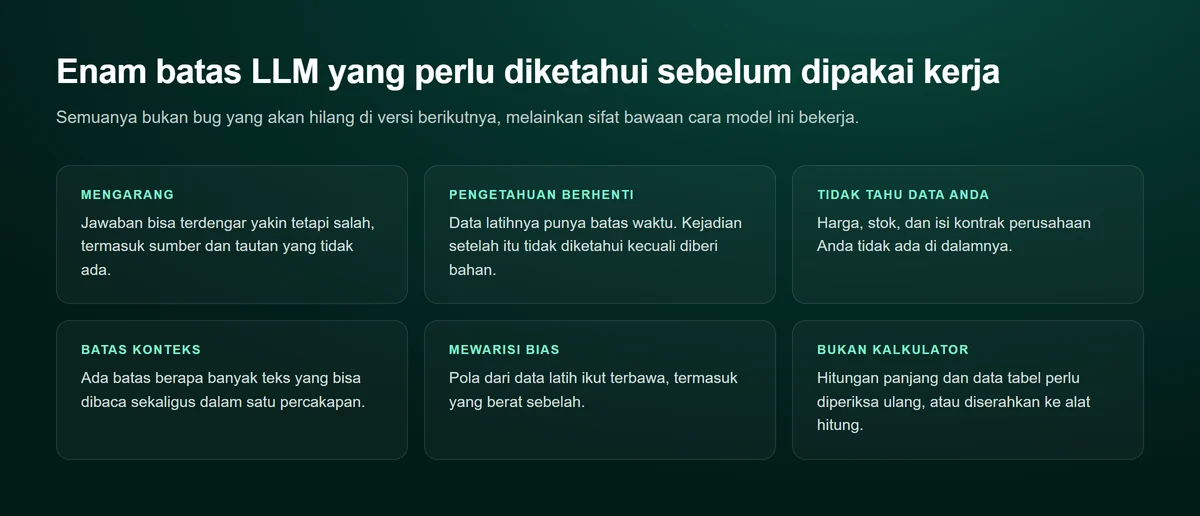
Enam batas yang tidak hilang di versi berikutnya
Keenamnya bukan cacat yang akan diperbaiki, melainkan sifat bawaan dari cara model ini bekerja. Diagram: Nalurika
Yang paling sering menimbulkan masalah di kantor adalah yang pertama. IBM menyebutnya halusinasi AI, yaitu ketika model menghasilkan informasi yang salah atau menyesatkan dan menyajikannya seolah fakta, mulai dari angka, kutipan, studi yang tidak ada, sampai alamat web yang tidak pernah ada (IBM). Karena bentuk kalimatnya tetap rapi dan yakin, kesalahan seperti ini sulit terlihat kalau pembacanya sedang terburu-buru.
Aturan praktis yang aman: perlakukan setiap keluaran sebagai draf dari asisten baru yang rajin tetapi belum bisa dipercaya untuk angka. Periksa semua angka, nama orang, nama perusahaan, kutipan aturan, dan tautan ke sumber aslinya sebelum dipakai di dokumen resmi atau dikirim ke pelanggan.
Cara membuat LLM mengenal data perusahaan Anda
Model tidak tahu harga, stok, atau isi prosedur internal Anda. Ada tiga cara umum memberinya bahan, dengan tingkat kerumitan berbeda.
Tempel langsung di percakapan. Paling cepat dan tanpa biaya tambahan, cocok untuk pekerjaan sekali jalan seperti merangkum satu kontrak. Batasnya adalah jendela konteks dan kerepotan mengulang tiap kali.
Sambungkan ke kumpulan dokumen. IBM menjelaskan retrieval augmented generation sebagai pola yang menghubungkan model ke basis pengetahuan eksternal supaya jawabannya berdasar bahan yang relevan dan mutakhir (IBM). Pola inilah yang dipakai asisten internal perusahaan. Prasyaratnya dokumen Anda tersusun rapi, seperti dibahas di artikel knowledge base.
Sambungkan ke sistem lewat API. Untuk data yang berubah tiap menit seperti stok dan status pesanan, jawabannya diambil langsung dari sistem sumber, bukan dari dokumen. Cara kerja sambungan ini dibahas di artikel API adalah.
Memakai LLM untuk pekerjaan, langkah demi langkah
Pilih satu pekerjaan nyata yang berulang dan memakan waktu, misalnya merangkum notulen atau menyusun balasan pertanyaan pelanggan yang itu-itu saja.
Tulis perintah lengkap. Sebutkan tugas, bahan, pembaca, bentuk hasil, dan batasannya. Tekniknya dibahas di artikel prompt engineering.
Bandingkan dengan hasil manusia. Jalankan di pekerjaan yang hasil benarnya sudah Anda ketahui, supaya terlihat di bagian mana model sering meleset.
Simpan perintah yang berhasil di satu tempat yang bisa diakses tim, sehingga tidak setiap orang mulai dari nol.
Tetapkan siapa yang memeriksa sebelum hasilnya keluar ke pelanggan. Ini langkah yang paling sering dilewati dan paling mahal akibatnya.
Kalau Anda ingin tim memakai AI dengan cara yang sama dan hasil yang bisa diperiksa, lengkap dengan contoh perintah dari pekerjaan sendiri dan aturan datanya, lihat kursus AI untuk pemilik usaha dan tim dari Nalurika. Artikel lain seputar AI untuk kerja ada di halaman artikel.
LLM adalah singkatan dari large language model, atau model bahasa besar. IBM mendefinisikannya sebagai model AI yang dilatih dengan sejumlah besar teks sehingga mampu memahami dan menghasilkan bahasa manusia. Kata besar merujuk pada dua hal sekaligus: banyaknya teks yang dipakai melatih dan banyaknya parameter di dalam modelnya.
LLM adalah mesinnya, ChatGPT adalah salah satu aplikasi yang memakai mesin itu. Perumpamaannya mirip mesin mobil dan mobilnya. Claude, Gemini, dan Copilot juga aplikasi yang dibangun di atas model bahasa besar, masing-masing dengan antarmuka, fitur, dan ketentuan datanya sendiri.
Token adalah potongan teks terkecil yang diproses model, bisa berupa satu kata utuh, penggalan kata, atau satu karakter. Dokumentasi Gemini API menyebut untuk model Gemini satu token setara sekitar empat karakter, dan 100 token kira-kira sama dengan 60 sampai 80 kata bahasa Inggris. Angka ini berbeda antarmodel dan antarbahasa.
Tidak dalam arti manusia mengerti. Model menghitung kelanjutan yang paling mungkin dari pola yang dipelajarinya, bukan memeriksa kebenaran. Itulah sebabnya jawaban bisa terdengar sangat yakin tetapi keliru, dan kenapa angka serta kutipan selalu perlu diperiksa ke sumber aslinya.
IBM menyebut gejala ini halusinasi AI: model menghasilkan informasi yang salah atau menyesatkan sambil menyajikannya seperti fakta, termasuk studi yang tidak ada dan tautan yang tidak pernah ada. Penyebabnya bukan niat berbohong, melainkan cara kerjanya yang menyusun kelanjutan paling masuk akal secara bahasa, bukan yang paling benar secara fakta.
Tidak, kecuali datanya diberikan. Harga, stok, isi kontrak, dan prosedur internal Anda tidak ada di dalam model. Ada dua cara umum memberikannya: menempelkan dokumen langsung di percakapan, atau menyambungkan model ke kumpulan dokumen perusahaan lewat pola yang disebut retrieval augmented generation, yang membuat model mengambil bahan dari sumber tepercaya sebelum menjawab.
Banyak aplikasi berbasis LLM punya paket gratis dengan batas pemakaian, dan ada pula model terbuka yang bisa dijalankan sendiri. Untuk pemakaian kantor yang rutin, yang menentukan biaya biasanya bukan harga per bulan saja, melainkan juga berapa banyak teks yang diproses, karena penagihan API umumnya dihitung per token masuk dan keluar.
Berbeda per penyedia dan per jenis paket. Paket konsumen sering memakai percakapan untuk meningkatkan model kecuali pengaturannya dimatikan, sedangkan paket organisasi dan API biasanya diatur ketentuan tersendiri. Periksa halaman privasi penyedia yang Anda pakai sebelum mengunggah dokumen kerja, dan tetapkan aturan internal tentang data apa yang boleh dimasukkan.
AI adalah payung besar untuk sistem yang meniru kemampuan berpikir manusia, termasuk pengenalan gambar, prediksi angka, dan pengelompokan data. LLM adalah satu jenis di dalamnya yang khusus menangani bahasa. Jadi semua LLM adalah AI, tetapi tidak semua AI adalah LLM.
Tim sudah memakai AI tetapi hasilnya masih perlu dirombak tiap kali?
Ceritakan pekerjaan apa yang ingin dibantu AI dan alat yang dipakai tim sekarang. Kami bantu menyusun contoh perintah dari pekerjaan Anda sendiri dan aturan pemakaian datanya. Kami membalas di jam kerja.