Disusun dengan bantuan AI. Angka dan kutipan dari pihak lain ditautkan ke sumber yang dibuka saat menulis.
RAG mengambil potongan dokumen yang relevan sebelum model menyusun jawaban. Ilustrasi: Nalurika
Jawaban AI yang terdengar lancar belum tentu berasal dari dokumen bisnis yang benar. RAG atau retrieval augmented generation dibuat untuk mengurangi masalah itu dengan mengambil potongan informasi dari sumber yang ditentukan sebelum model menyusun jawaban. Dengan pendekatan ini, AI tidak hanya mengandalkan pola bahasa yang pernah dipelajari. Namun RAG juga bukan jaminan bebas halusinasi. Kualitas hasil tetap mengikuti kualitas sumber, pencarian, izin, dan cara jawaban diverifikasi.
Artikel ini membahas RAG dari sudut pandang tim bisnis yang ingin AI menjawab berdasarkan dokumen sendiri. Kami merujuk ke makalah asli RAG dan dokumentasi resmi AWS, Google Cloud, dan Microsoft, lalu menerjemahkannya ke keputusan praktis: dokumen mana yang disiapkan, bagaimana izin dijaga, bagaimana hasil diperiksa, dan kapan proyek perlu dihentikan. Semua langkah yang kami sarankan bisa diuji pada skala kecil lebih dulu.
Untuk menghubungkan pembahasan dengan langkah bisnis berikutnya, lihat halaman jasa AI dan bandingkan kebutuhan tim Anda dengan proses yang sudah dijelaskan di atas.
Apa itu RAG?
Jawaban singkat: RAG adalah pendekatan yang mengambil informasi relevan dari sumber eksternal lalu memasukkannya ke konteks model sebelum jawaban dibuat.
Dalam sistem RAG, dokumen bisnis disiapkan agar dapat dicari. Ketika pengguna bertanya, sistem melakukan retrieval untuk mencari potongan yang paling terkait. Potongan tersebut dikirim sebagai konteks bersama pertanyaan. Model kemudian menyusun jawaban dengan mengacu pada konteks itu. Jika sumber tidak memuat jawaban, sistem yang baik harus bisa mengatakan bahwa informasi belum ditemukan, bukan mengisi kekosongan dengan kalimat yang terdengar yakin.
Istilah RAG berasal dari makalah Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks karya Patrick Lewis dan rekan, yang diterima di NeurIPS 2020. Makalah itu menggabungkan dua jenis memori: memori parametrik berupa model seq2seq yang sudah dilatih, dan memori non-parametrik berupa indeks vektor Wikipedia yang diakses dengan retriever neural. Hasilnya, untuk tugas pembuatan teks, model RAG menghasilkan bahasa yang lebih spesifik, beragam, dan faktual dibanding pembanding yang hanya mengandalkan parameter model.
Mengapa RAG berbeda dari melatih ulang model?
Jawaban singkat: RAG menambahkan konteks ketika pertanyaan dibuat, sedangkan pelatihan ulang mengubah parameter model melalui proses pelatihan.
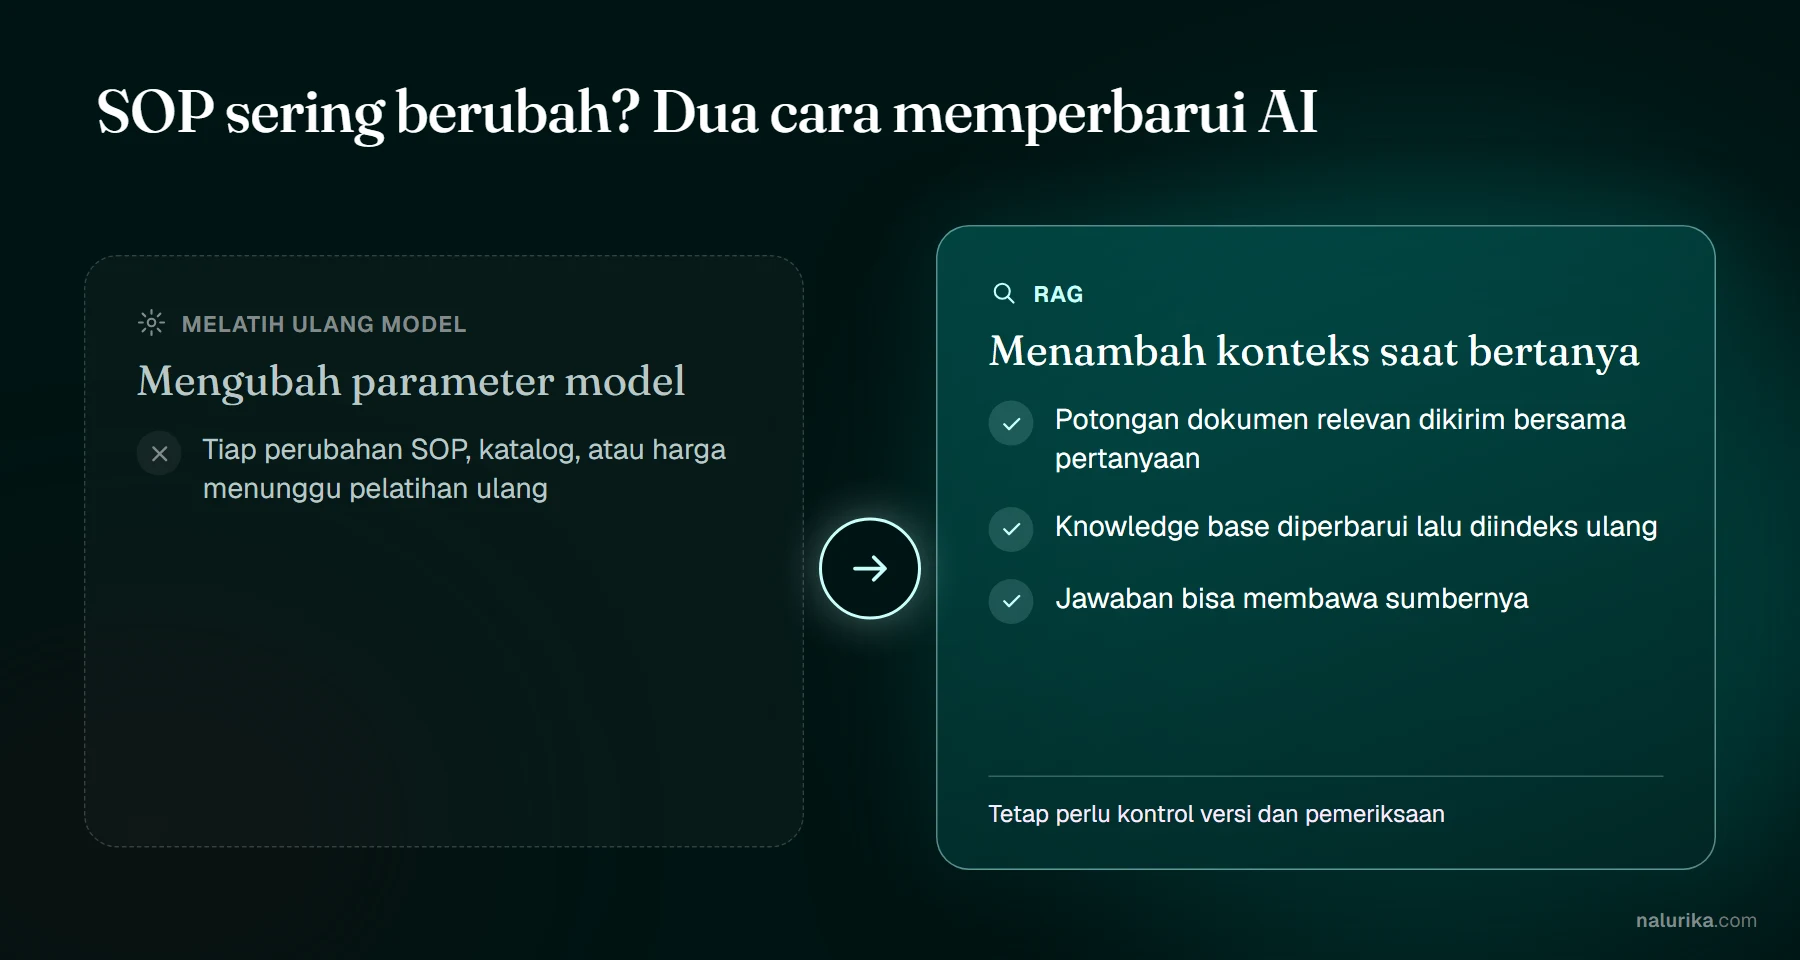
Perbedaan ini penting untuk dokumen yang sering berubah. SOP, katalog, kebijakan, dan daftar harga tidak selalu perlu dimasukkan ke proses training. Dengan RAG, isi knowledge base dapat diperbarui dan diindeks kembali sesuai kebutuhan. Walaupun demikian, perubahan sumber tetap membutuhkan kontrol versi dan pemeriksaan. RAG tidak menghilangkan biaya pemrosesan, penyimpanan, evaluasi, atau pengamanan dokumen.
AWS menjelaskan alasan ekonominya: biaya komputasi dan finansial untuk melatih ulang foundation model dengan informasi khusus organisasi itu tinggi, sehingga RAG menjadi cara yang lebih hemat untuk memasukkan data baru ke LLM. Makalah asli RAG juga menyebut dua masalah yang belum terpecahkan pada model yang hanya mengandalkan parameter, yaitu memberi asal-usul (provenance) jawaban dan memperbarui pengetahuannya (Lewis dkk., 2020). Indeks dokumen yang bisa diperbarui adalah jawaban RAG untuk kedua masalah itu.
Untuk dokumen yang sering berubah, RAG memperbarui pengetahuan lewat indeks, bukan lewat pelatihan ulang. Kontrol versi tetap diperlukan. Diagram: Nalurika
Tahap menyiapkan dokumen
Jawaban singkat: RAG yang dapat dipercaya dimulai dari inventaris sumber, bukan dari memilih model paling besar.
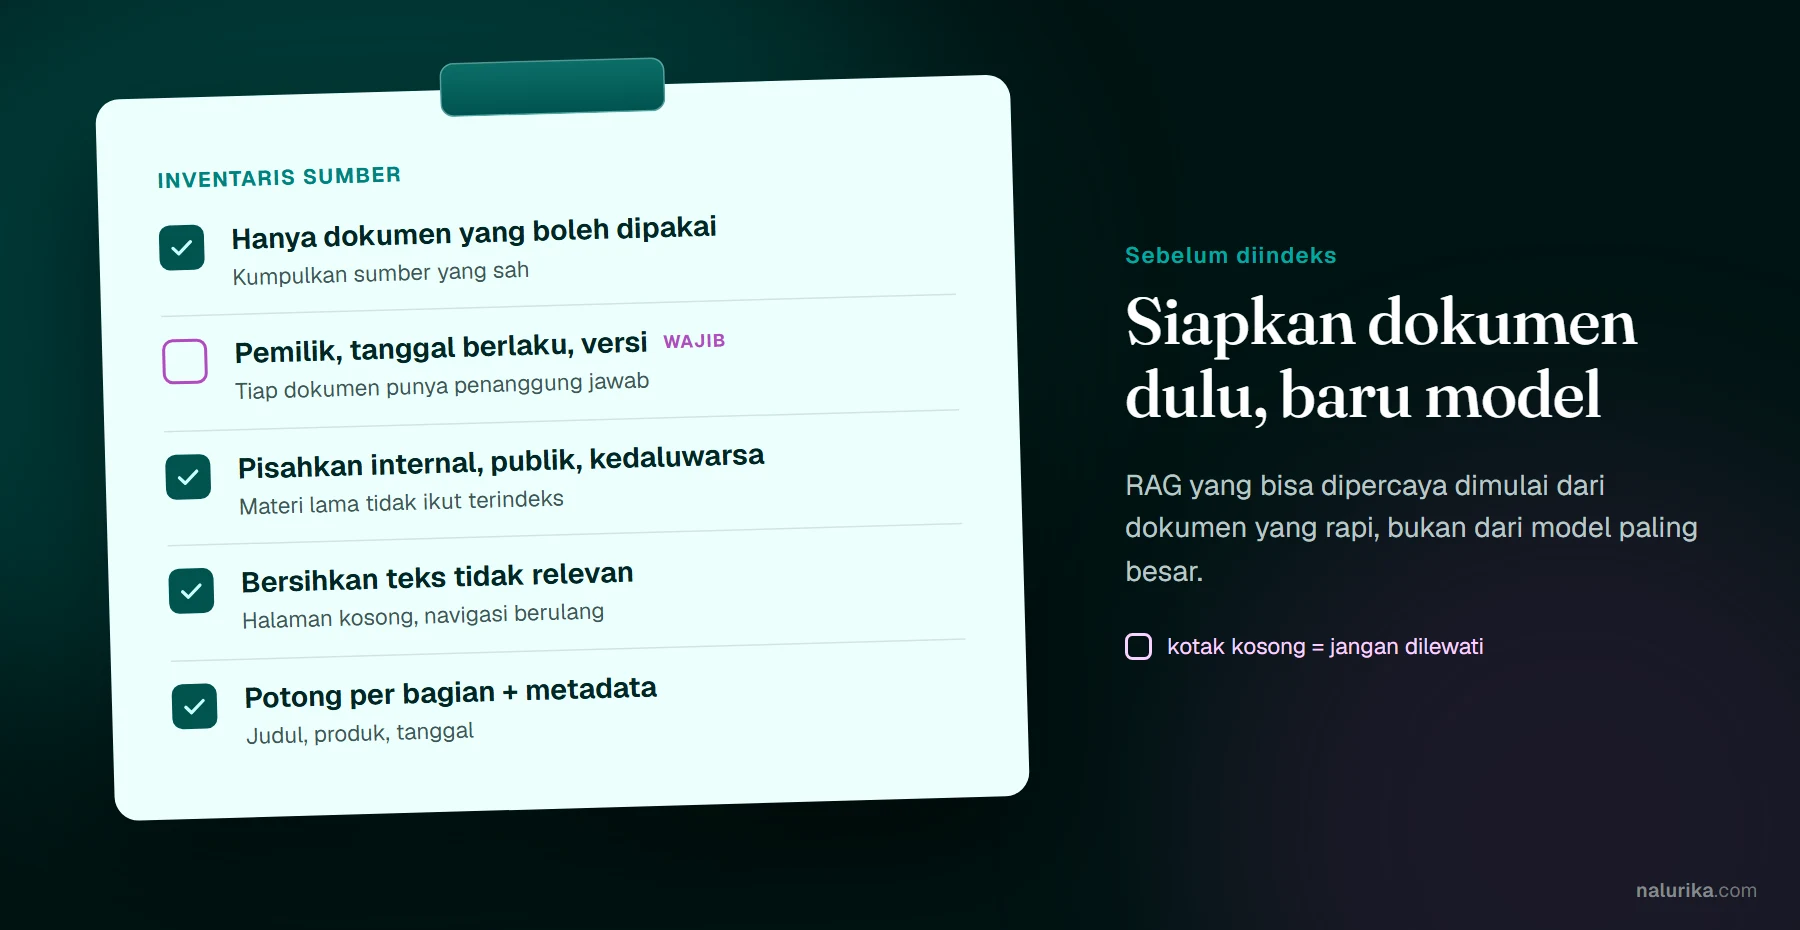
Kumpulkan dokumen yang benar-benar boleh digunakan, beri pemilik, tanggal berlaku, dan status versi. Pisahkan dokumen internal, dokumen publik, dan materi yang sudah tidak berlaku. Bersihkan halaman kosong, navigasi berulang, dan teks yang tidak relevan. Potong dokumen menjadi bagian yang masih menyimpan konteks, lalu simpan metadata seperti judul, bagian, produk, dan tanggal. Metadata membantu filter sebelum pencarian semantik dilakukan.
Dokumentasi Azure AI Search tentang RAG merangkum dua pekerjaan utama saat indexing: chunking, yaitu memecah dokumen besar menjadi bagian yang bisa dicocokkan secara terpisah, dan vektorisasi, yaitu membuat embedding untuk pencarian vektor. Karena itu, struktur dokumen sumber ikut menentukan hasil. Judul bagian yang jelas, satu topik per bagian, dan tabel yang tidak terpotong akan menghasilkan potongan yang lebih mudah ditemukan saat pengguna bertanya.
Persiapan dokumen sebelum diindeks. Tanpa pemilik dan versi, jawaban sulit ditelusuri ke sumber yang berlaku. Diagram: Nalurika
Cara kerja retrieval dan konteks
Jawaban singkat: Retrieval mencari kandidat potongan dokumen, melakukan penyaringan atau pengurutan, lalu menyusun konteks yang dikirim ke model.
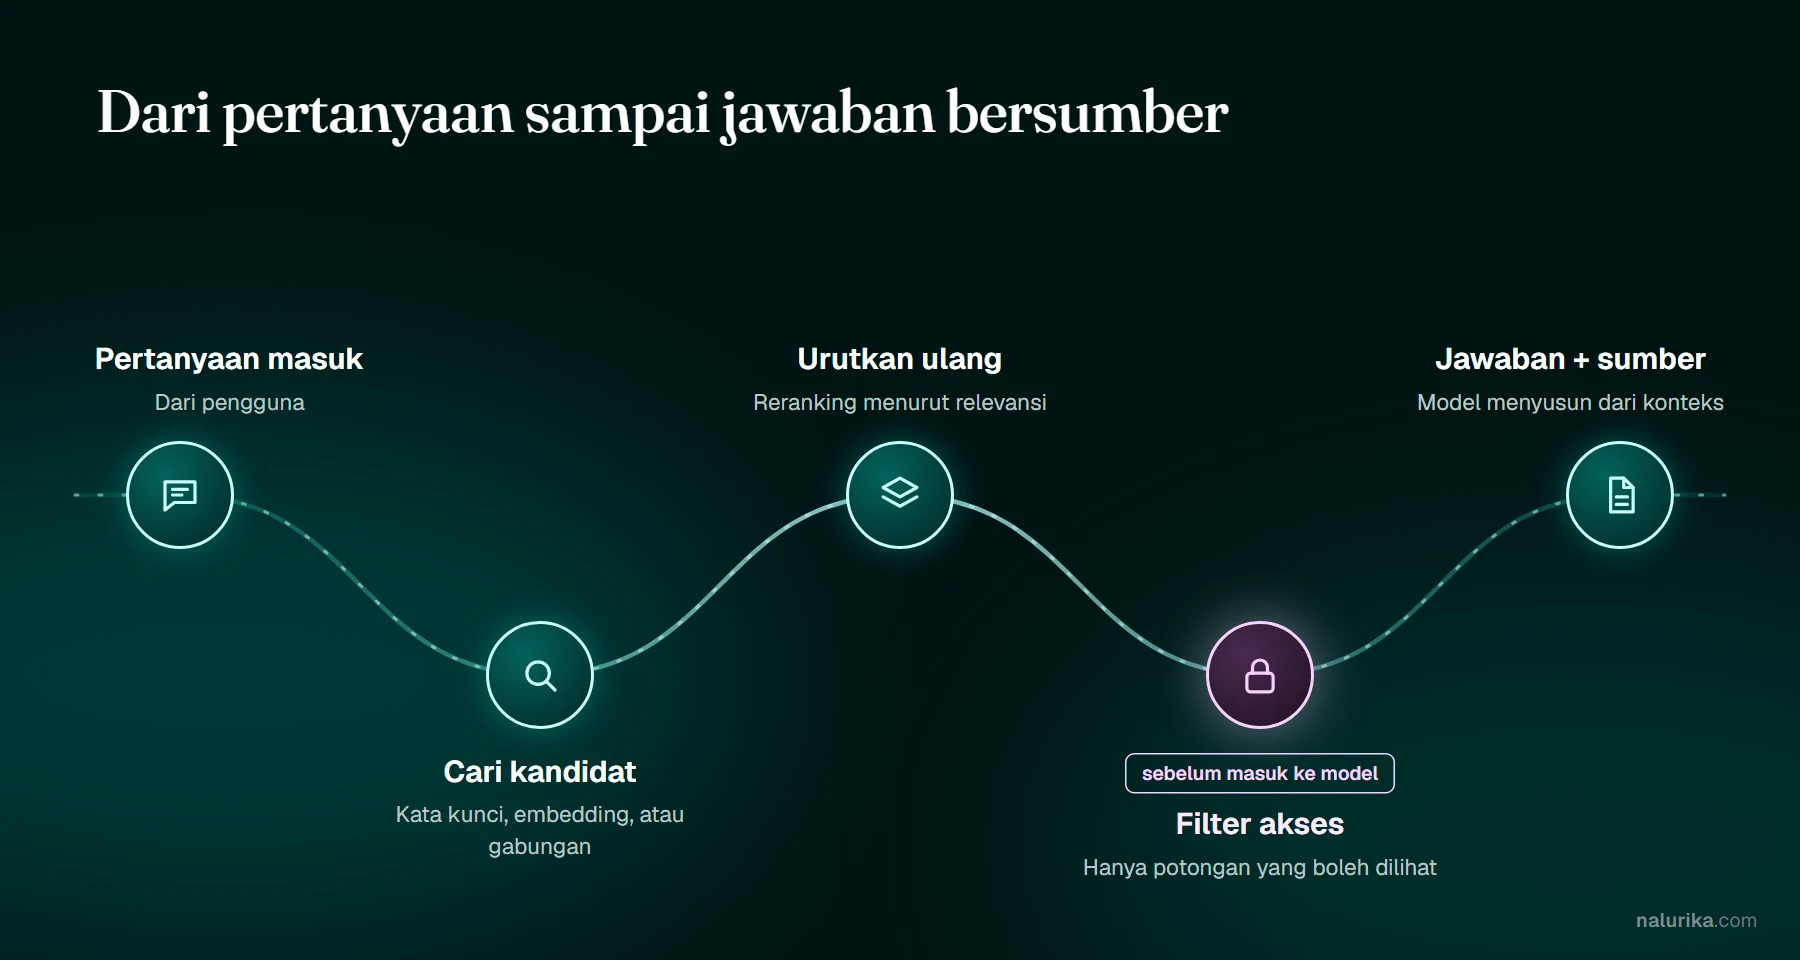
Pencarian dapat memakai kata kunci, embedding, atau gabungan keduanya. Hasil pertama belum tentu paling tepat, sehingga sistem sering melakukan reranking berdasarkan relevansi. Filter akses harus berjalan sebelum potongan diberikan kepada model. Konteks yang terlalu sedikit membuat jawaban kehilangan syarat penting. Konteks yang terlalu banyak membuat model bingung dan menambah biaya. Ukuran potongan perlu diuji memakai pertanyaan nyata dari pengguna.
Menurut Google Cloud, mesin pencari yang lebih maju memakai pencarian semantik dan pencarian kata kunci sekaligus (hybrid search), lalu memakai re-ranker untuk memberi skor agar hasil teratas benar-benar paling relevan. Pencarian juga bekerja lebih baik dengan query yang jelas dan tanpa salah ketik, sehingga sebagian sistem mengubah query dan memperbaiki ejaan sebelum mencari. Microsoft menyarankan hal serupa: query hybrid untuk recall yang maksimal dan semantic ranking untuk mengurutkan hasil.
Filter akses harus berjalan sebelum potongan dokumen diberikan ke model, bukan diserahkan ke instruksi prompt. Diagram: Nalurika
Contoh RAG untuk bisnis
Jawaban singkat: RAG cocok untuk tanya jawab SOP, pencarian kebijakan layanan, ringkasan knowledge base, dan bantuan internal yang membutuhkan sumber jelas.
Tim customer service dapat menanyakan prosedur refund dan melihat bagian SOP yang menjadi dasar. Tim sales dapat mencari informasi produk dari katalog yang disetujui. Tim operasional dapat bertanya tentang alur eskalasi. Pada setiap kasus, jawaban harus membawa sumber atau potongan rujukan agar pengguna dapat memeriksa konteksnya. Jangan menjadikan RAG sebagai alasan untuk menghapus proses persetujuan pada tindakan yang berdampak ke pelanggan.
Layanan terkelola sudah menyediakan banyak bagian ini. Amazon Bedrock Knowledge Bases, misalnya, dapat menyertakan sitasi dalam jawaban sehingga sumber aslinya bisa dirujuk dan akurasinya bisa dicek. Versi terkelolanya menyediakan konektor ke Amazon S3, SharePoint, Confluence, Google Drive, OneDrive, dan web crawler. Untuk bisnis yang dokumennya sudah tersimpan di Google Drive atau SharePoint, ini berarti proyek RAG tidak selalu harus dimulai dengan memindahkan semua dokumen ke sistem baru.
Batasan dan sumber halusinasi
Jawaban singkat: RAG dapat gagal ketika dokumen salah, retrieval mengambil bagian yang keliru, konteks bertentangan, atau pertanyaan berada di luar cakupan sumber.
Saat menguji RAG, buat kumpulan pertanyaan yang mencakup pertanyaan langsung, pertanyaan dengan istilah berbeda, pertanyaan yang jawabannya tidak ada, serta pertanyaan yang membutuhkan dua dokumen. Ukur apakah sistem menemukan sumber tepat dan apakah jawaban tidak melampaui sumber. Tanda seperti sitasi yang tidak cocok, jawaban terlalu umum, dan kepercayaan diri berlebihan perlu diperlakukan sebagai kegagalan, bukan sekadar gaya bahasa.
AWS mencatat empat tantangan LLM yang menjadi alasan RAG dipakai: memberi informasi palsu ketika tidak tahu jawabannya, memberi informasi usang atau terlalu umum ketika pengguna butuh jawaban spesifik dan terbaru, menyusun jawaban dari sumber yang tidak otoritatif, dan keliru karena istilah yang sama dipakai untuk hal berbeda di sumber pelatihan. AWS menyebut RAG sebagai salah satu pendekatan untuk mengatasi sebagian tantangan itu, bukan seluruhnya. Karena itu, uji kegagalan tetap wajib walau sistem sudah memakai RAG.
Akses, privasi, dan versi dokumen
Jawaban singkat: Knowledge base RAG harus mengikuti izin dokumen sehingga pengguna tidak memperoleh informasi yang sebenarnya tidak boleh ia lihat.
Pisahkan indeks berdasarkan ruang kerja atau atribut akses. Jangan hanya mengandalkan instruksi dalam prompt untuk menyembunyikan data. Simpan jejak versi sumber yang dipakai dalam jawaban. Jika dokumen dicabut, proses reindex dan cache invalidation perlu diuji. Data pelanggan, kontrak, dan informasi karyawan memerlukan aturan retention yang jelas. Tim legal atau security perlu dilibatkan saat RAG menyentuh data pribadi.
Microsoft memberi contoh yang mudah dibayangkan: data keuangan seharusnya hanya bisa diakses tim keuangan, bahkan ketika seorang eksekutif bertanya ke chatbot. Solusi yang disebutkan antara lain security trimming per dokumen dan filter keamanan saat query berjalan. Amazon Bedrock Knowledge Bases versi terkelola menerapkan penyaringan izin per dokumen memakai Access Control List saat retrieval, kecuali untuk sumber web crawler. Polanya sama: izin diperiksa sebelum potongan dokumen sampai ke model.
Cara memilih proyek RAG pertama
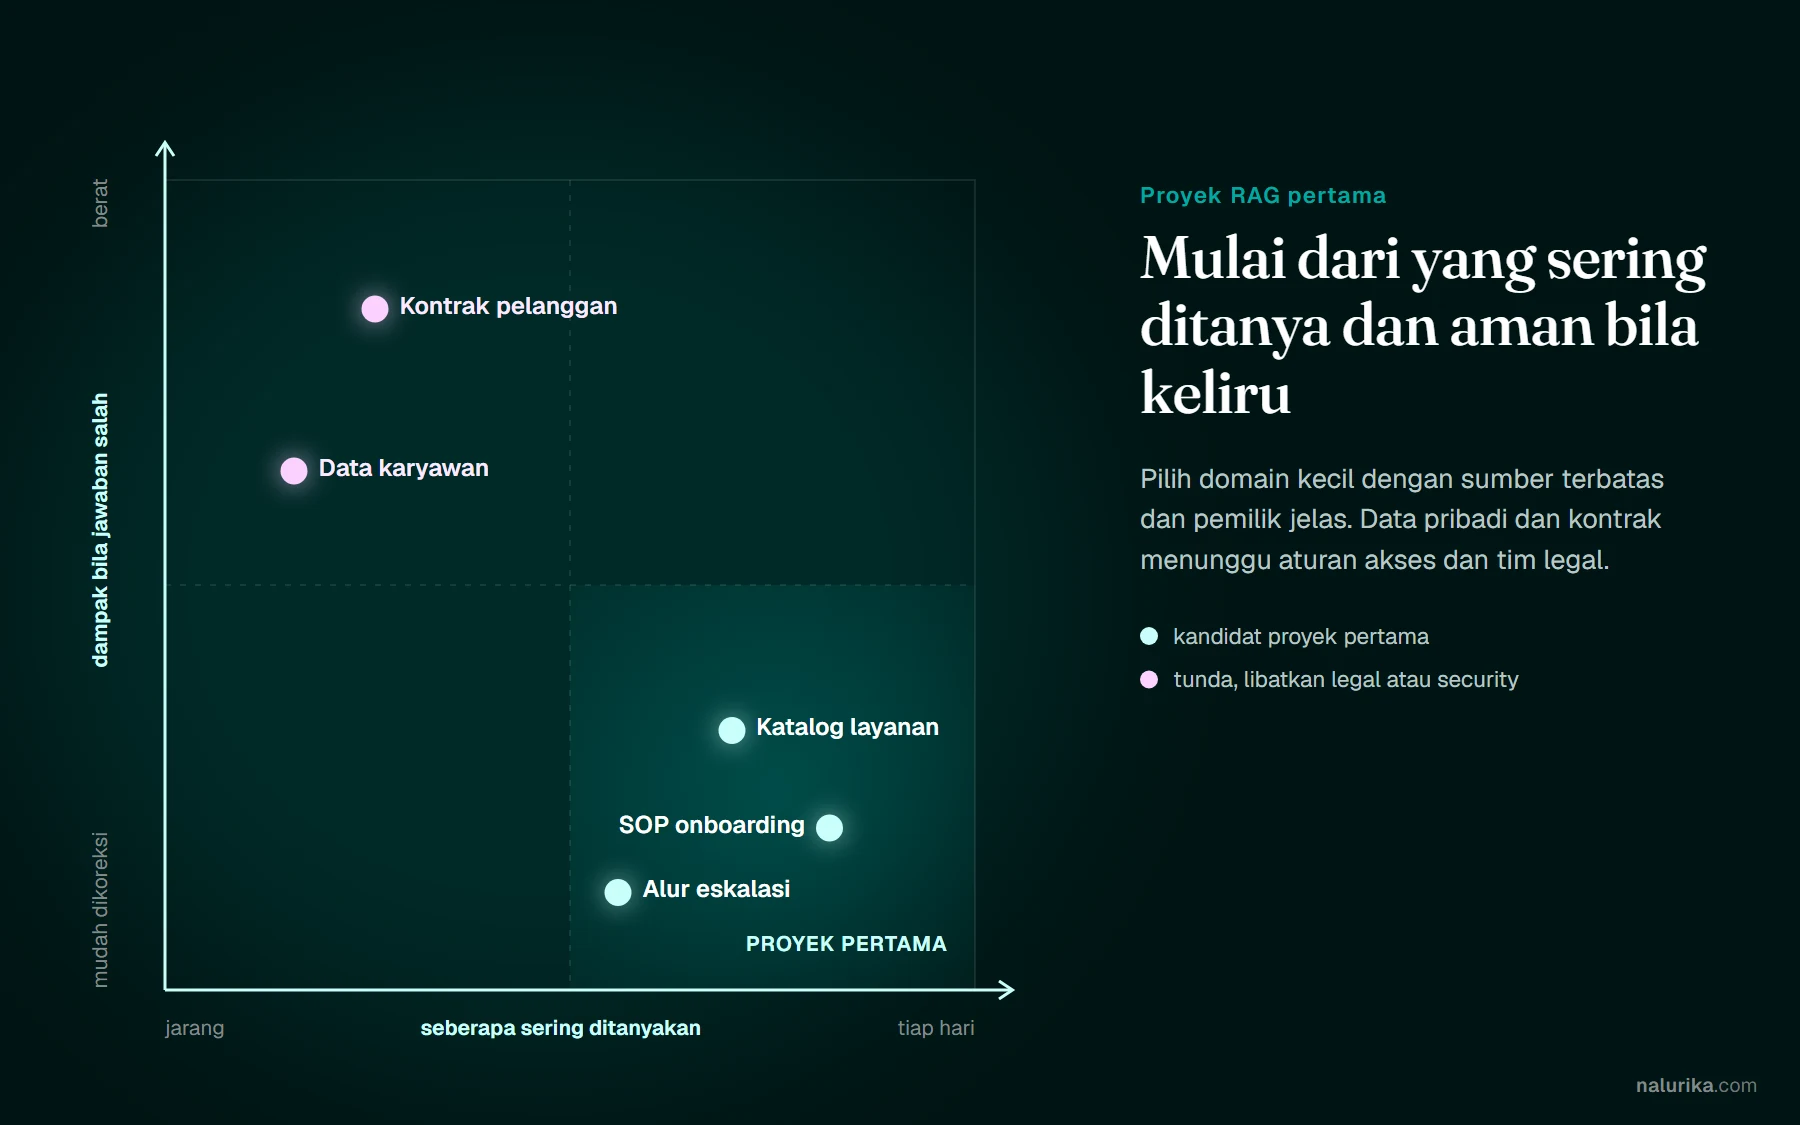
Jawaban singkat: Proyek RAG pertama sebaiknya memiliki sumber terbatas, pemilik konten yang jelas, pertanyaan berulang, dan dampak kesalahan yang dapat dikendalikan.
Pilih satu domain kecil seperti SOP onboarding atau katalog layanan. Tentukan pertanyaan yang ingin dijawab, sumber yang sah, jawaban yang diharapkan, dan orang yang memeriksa hasil. Uji sistem dengan dataset tertutup sebelum membuka akses luas. Tetapkan kapan jawaban harus ditolak atau diteruskan kepada manusia. Setelah kualitas stabil, perluas sumber secara bertahap dan dokumentasikan perubahan sehingga evaluasi tidak kehilangan konteks.
Salah satu manfaat RAG yang disebut AWS adalah kepercayaan pengguna: jawaban dapat menyertakan sitasi, dan pengguna bisa membuka dokumen sumbernya sendiri bila butuh detail. Untuk proyek pertama, jadikan sitasi ini syarat lulus. Setiap jawaban dalam uji coba harus menunjuk ke bagian dokumen yang benar, dan pemeriksa mencatat jawaban yang sumbernya tidak cocok. Angka itu menjadi dasar keputusan untuk memperluas atau menunda proyek.
Proyek RAG pertama sebaiknya sering dipakai dan mudah dikoreksi bila keliru. Data pribadi dan kontrak menunggu aturan akses dan keterlibatan tim legal atau security. Diagram: Nalurika
Checklist penerapan yang aman
Sebelum memakai pendekatan ini pada proses nyata, gunakan checklist berikut. Checklist tidak menggantikan penilaian pemilik proses, tetapi membantu memastikan pertanyaan dasar tidak terlewat. Pilih ruang lingkup yang kecil agar kesalahan dapat dikoreksi tanpa memengaruhi seluruh operasi. Setelah uji pertama, catat perubahan yang terjadi dan perbarui dokumentasi yang dibaca tim.
Hal yang diperiksa
Pertanyaan praktis
Bukti minimum
Tujuan
Masalah apa yang ingin dikurangi?
Definisi masalah dan pemilik
Data
Data apa yang dipakai dan boleh diakses?
Daftar sumber dan izin
Kontrol
Kapan manusia memeriksa atau menyetujui?
Checklist review
Kegagalan
Apa yang terjadi jika langkah gagal?
Jalur eskalasi dan log
Evaluasi
Bagaimana kualitas hasil dibaca?
Contoh uji dan catatan hasil
Catatan implementasi untuk tim
Di minggu pertama, gunakan satu contoh kerja yang sudah selesai sebagai bahan pembelajaran. Tulis kondisi awal, siapa yang mengerjakan, data yang dipakai, dan bagian yang paling sering membutuhkan koreksi. Untuk rag adalah, contoh nyata lebih berguna daripada daftar fitur karena membantu tim melihat batas konsep dan membuat definisi selesai yang dapat diperiksa. Simpan pertanyaan yang belum terjawab agar tidak hilang ketika diskusi berpindah ke pemilihan tool.
Di minggu kedua, buat percobaan dengan ruang lingkup kecil dan pemilik yang jelas. Minta pengguna proses menjalankan contoh, lalu catat bagian yang terasa membingungkan. Jangan hanya mengukur apakah sistem menyala. Perhatikan apakah hasilnya bisa dibaca, apakah data yang dipakai memang sah, dan apakah orang yang bertanggung jawab tahu apa yang harus dilakukan ketika hasil tidak sesuai. Catatan ini menjadi dasar untuk memperbaiki rag adalah tanpa menambah kompleksitas yang belum diperlukan.
Sinyal untuk melanjutkan adalah hasil uji konsisten, sumber dapat ditelusuri, dan kesalahan memiliki jalur penanganan. Sinyal untuk berhenti adalah data tidak lengkap, izin tidak jelas, pemilik tidak tersedia, atau hasil tampak meyakinkan tetapi tidak dapat diverifikasi. Berhenti pada tahap ini bukan kegagalan. Itu cara menjaga agar eksperimen rag-adalah tidak berubah menjadi masalah operasional yang lebih mahal.
Dokumentasikan keputusan dalam bahasa yang dipahami tim nonteknis. Tuliskan apa yang dilakukan, apa yang tidak dilakukan, data apa yang dikecualikan, dan kapan review berikutnya dilakukan. Dokumentasi singkat membantu orang lain mengulang hasil, menemukan perubahan, dan memberi umpan balik yang spesifik. Ia juga mencegah pengetahuan hanya tersimpan di percakapan pribadi atau di kepala satu orang.
Jika hasil percobaan diterima, perluas satu bagian pada satu waktu. Setelah setiap perluasan, ulangi pemeriksaan kualitas, akses, error, dan pengalaman pengguna. Jangan menggabungkan perubahan proses, tool, dan target sekaligus karena penyebab masalah akan sulit dibedakan. Cara bertahap membuat perbaikan rag adalah lebih mudah dipertahankan ketika volume kerja meningkat atau anggota tim berganti.
Terakhir, tentukan pemilik yang dapat mengambil keputusan setelah artikel ini dibaca. Pemilik tersebut tidak harus membangun semuanya sendiri, tetapi harus mampu menjawab kapan proses dipakai, kapan ditolak, bagaimana data dilindungi, dan kepada siapa kasus khusus diteruskan. Dengan peran yang jelas, pembelajaran dari batch awal bisa menjadi kebiasaan kerja yang sehat, bukan sekadar eksperimen yang berhenti setelah publikasi.
Glosarium kerja khusus: rag adalah
RAG memiliki kosakata teknis yang menjelaskan mengapa jawaban dapat lebih terarah. Corpus adalah kumpulan sumber, ingestion adalah proses memasukkan dokumen, sedangkan chunking memecah dokumen menjadi unit yang dapat dicari. Embedding mengubah potongan teks menjadi vektor semantik. Vector index menyimpan representasi itu, sementara retriever memilih kandidat. Top-k menentukan jumlah kandidat awal. Reranker menyusun ulang kandidat berdasarkan relevansi yang lebih halus. Hybrid search menggabungkan pencarian kata kunci dengan kemiripan vektor. Metadata filter dapat membatasi departemen, tanggal berlaku, atau tingkat kerahasiaan.
Grounding bukan sinonim dari kebenaran otomatis. Sistem tetap perlu citation, source window, dan aturan abstain ketika bukti kurang. Query rewriting membantu pertanyaan pendek menjadi pencarian yang lebih lengkap, tetapi transformasinya harus bisa dilihat saat debugging. Context budget menentukan berapa banyak potongan yang dapat dikirim ke model. Overlap antar chunk menjaga kalimat tidak terpotong, namun overlap berlebihan memperbesar biaya. Deduplication mencegah satu fakta muncul berkali-kali dan terlihat seolah memiliki banyak bukti. Freshness policy menentukan kapan dokumen lama dikeluarkan dari index.
Pipeline RAG yang sehat menguji precision, recall, faithfulness, dan answer relevancy dengan dataset pertanyaan nyata. Benchmark tidak boleh hanya memakai pertanyaan yang mudah. Masukkan typo, istilah internal, pertanyaan lintas dokumen, dan permintaan yang memang tidak memiliki jawaban. Evaluator perlu memisahkan kegagalan retrieval dari kegagalan generation. Jika dokumen yang tepat tidak masuk context, masalahnya berada pada parsing, chunking, embedding, index, atau ranking. Jika bukti sudah benar tetapi jawaban melenceng, periksa prompt, format output, dan instruksi prioritas.
Di sisi operasional, siapkan ingestion log, document ID, checksum, timestamp, dan owner sumber. Hak akses harus diterapkan sebelum retrieval, bukan setelah jawaban dibuat. Cache boleh mempercepat permintaan berulang, tetapi harus memiliki invalidation saat kebijakan berubah. RAG untuk kebijakan HR, kontrak, atau prosedur keselamatan memerlukan review manusia dan jalur eskalasi. Tim dapat memulai dengan satu folder yang terkontrol, mengukur pertanyaan yang gagal, kemudian memperbaiki index berdasarkan bukti. Nilai RAG muncul dari siklus perawatan, bukan dari demo pertama.
Kesimpulan
RAG membuat AI mencari potongan dokumen yang relevan sebelum menjawab, sehingga pengetahuan bisa diperbarui lewat indeks tanpa melatih ulang model dan jawaban bisa membawa sitasi. Kualitasnya tetap bergantung pada empat hal: dokumen sumber yang rapi dan berlaku, pencarian yang tepat (chunking, embedding, hybrid search, reranking), izin yang diperiksa sebelum dokumen sampai ke model, dan evaluasi yang sengaja memasukkan pertanyaan tanpa jawaban. Langkah berikutnya bukan membeli tool secara terburu-buru, melainkan memilih satu domain kecil, menjadikan sitasi yang benar sebagai syarat lulus, lalu memperluas cakupan setelah hasilnya konsisten.
Ceritakan proses, tim, dan kendala yang ingin Anda rapikan. Kami bantu memetakan langkah yang masuk akal untuk bisnis Anda. Kami membalas di jam kerja.