Disusun dengan bantuan AI. Angka dan kutipan dari pihak lain ditautkan ke sumber yang dibuka saat menulis.
AI bekerja berlapis: data di bawah, pelatihan di tengah, dan jawaban di atas. Ilustrasi: Nalurika
Cara kerja AI pada dasarnya begini: AI belajar dari banyak contoh data untuk mengenali pola, lalu memakai pola itu untuk menebak jawaban atas data baru. Proses belajarnya disebut pelatihan, dan proses memakai hasil belajarnya disebut inferensi. Semua kemampuan AI yang Anda lihat, dari filter spam sampai ChatGPT, berdiri di atas tiga bahan yang sama: data, algoritma, dan daya komputasi.
Google Cloud menjelaskan bahwa sistem AI belajar dari data dalam jumlah besar, mengenali pola untuk membuat prediksi atau keputusan, tanpa diprogram secara eksplisit untuk setiap skenario. Mereka juga menegaskan bahwa semua teknik AI, seberagam apa pun, pada dasarnya bergantung pada data, algoritma, dan daya komputasi (Google Cloud).
Artikel ini menjelaskan cara kerja AI tanpa rumus: bedanya AI berbasis aturan dan machine learning, apa yang terjadi saat AI dilatih dan dipakai, bagaimana model bahasa seperti ChatGPT menyusun jawaban, kenapa AI bisa keliru, dan apa artinya untuk tim yang mulai memakai AI. Kalau Anda baru mulai, artikel ini cocok dibaca bersama panduan belajar AI dari nol.
AI berbasis aturan dan machine learning
Ada dua cara besar membuat komputer tampak "pintar". Cara pertama adalah menulis aturannya satu per satu. Cara kedua adalah memberi banyak contoh dan membiarkan komputer menemukan aturannya sendiri.
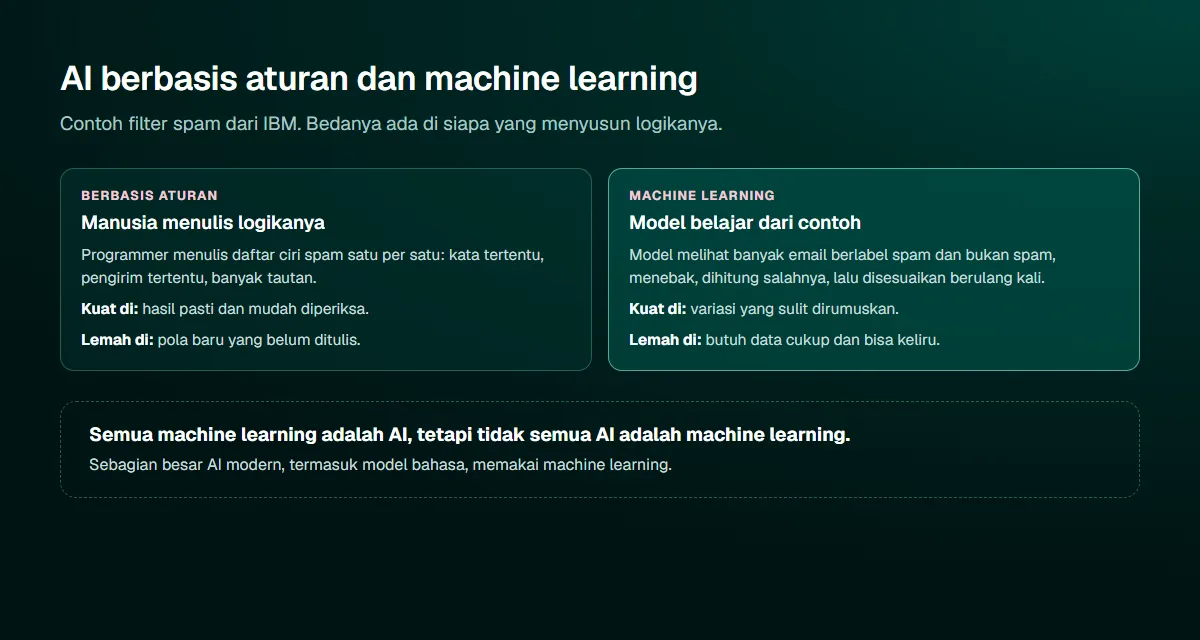
IBM memberi contoh filter spam. Dengan pendekatan aturan, programmer menulis daftar ciri spam secara manual. Dengan machine learning, model diperlihatkan contoh email dan diminta menebak mana yang spam; kesalahan tebakannya dihitung, algoritmanya disesuaikan untuk mengurangi kesalahan, dan proses ini diulang sampai tebakannya akurat. Model yang sudah terlatih itu secara tidak langsung telah belajar mengenali spam (IBM).
Sistem aturan mengikuti logika yang ditulis manusia, machine learning menemukan polanya dari contoh. Diagram: Nalurika
Diringkas dari penjelasan IBM tentang machine learning; contoh bisnis adalah ilustrasi kami.
Aspek
Berbasis aturan
Machine learning
Asal logika
Ditulis manual oleh manusia
Dipelajari dari contoh data
Kelebihan
Mudah diperiksa, hasilnya pasti
Luwes menghadapi variasi yang sulit dirumuskan
Kelemahan
Rapuh saat kasus makin rumit
Butuh data yang cukup dan bisa keliru
Contoh di bisnis
Menu chatbot "ketik 1 untuk harga"
Mengenali maksud chat yang ditulis bebas
IBM menulis bahwa makin rumit tugasnya, makin rapuh model berbasis aturan, karena sering mustahil mendefinisikan setiap pola dan variabel secara eksplisit. Itulah sebabnya machine learning kini menjadi tulang punggung sebagian besar sistem AI modern. Ringkasnya: semua machine learning adalah AI, tetapi tidak semua AI adalah machine learning (IBM). Perbedaan ini juga terlihat di dunia chatbot: ada chatbot menu berbasis aturan, ada chatbot yang memahami kalimat bebas.
Tiga bahan dasar: data, algoritma, dan komputasi
Data adalah bahan belajar. Google Cloud menyebut kualitas dan jumlah data pelatihan sangat menentukan kinerja AI. Data bisa berupa teks, gambar, angka penjualan, rekaman suara, atau riwayat chat.
Algoritma adalah resep belajarnya: cara model menyesuaikan dirinya supaya tebakannya makin tepat. IBM memberi contoh sederhana model penebak harga rumah dari luas bangunan, jumlah kamar, dan umur rumah. Bobot untuk tiap faktor itu disebut parameter, dan tujuan machine learning adalah menemukan nilai parameter yang menghasilkan tebakan paling akurat (IBM). Model AI modern punya parameter dalam jumlah yang sangat besar, tetapi prinsipnya sama.
Daya komputasi adalah tenaga untuk mengolah data sebanyak itu. Inilah alasan pelatihan model besar dilakukan perusahaan dengan pusat data raksasa, sementara kita sebagai pengguna cukup memakai hasilnya lewat aplikasi.
Di dalam machine learning ada cabang yang disebut deep learning, yang memakai jaringan saraf tiruan berlapis-lapis untuk belajar dari data. Menurut IBM, deep learning telah menjadi arsitektur terdepan di hampir semua bidang tempat AI dipakai, termasuk model bahasa besar.
Pelatihan dan inferensi: dua fase hidup sebuah model
Cara paling mudah memahami cara kerja AI adalah memisahkan dua fase. Fase pertama terjadi sekali (atau sesekali) di tempat pembuat model. Fase kedua terjadi setiap kali Anda memakai AI.
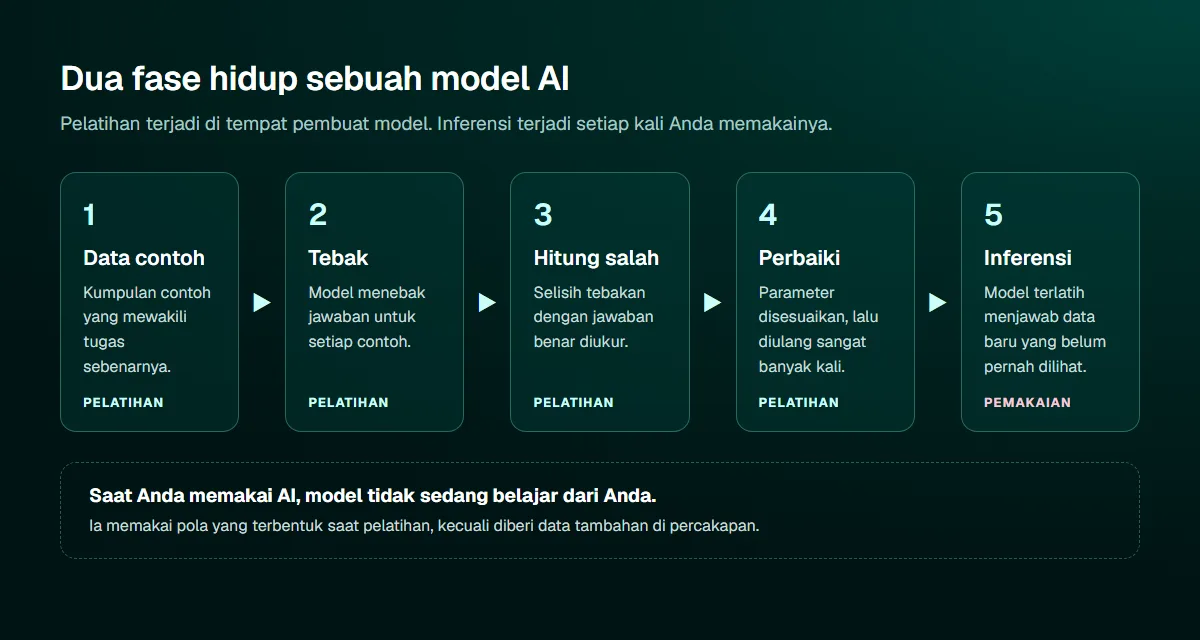
Pelatihan membentuk model dari contoh, inferensi memakai model itu untuk data baru. Diagram: Nalurika
Pelatihan. Model diberi contoh, menebak, dihitung kesalahannya, lalu parameternya disesuaikan. Siklus ini diulang sangat banyak kali.
Pengujian. Model dicoba pada data yang belum pernah dilihatnya. IBM menyebut tujuan utama machine learning adalah generalisasi, yaitu kemampuan membawa kinerja bagus dari data latihan ke situasi nyata.
Inferensi. Model yang sudah jadi dipakai untuk tugas sebenarnya. IBM menyebut penerapan model terlatih ini sebagai AI inference: model menerapkan pola yang dipelajarinya untuk menebak keluaran yang benar.
Implikasinya penting untuk pemakaian sehari-hari. Saat Anda mengetik pertanyaan di aplikasi AI, model itu tidak sedang belajar dari Anda secara langsung. Ia memakai pola yang sudah terbentuk saat pelatihan. Karena itu informasi yang muncul setelah pelatihan selesai bisa tidak diketahuinya, kecuali aplikasinya dilengkapi pencarian web atau dokumen yang Anda unggah.
Cara model bahasa seperti ChatGPT menyusun jawaban
ChatGPT, Gemini, dan Claude memakai model bahasa besar (large language model atau LLM). IBM mendefinisikan LLM sebagai model deep learning yang dilatih dengan data dalam jumlah sangat besar sehingga mampu memahami dan menghasilkan bahasa alami. LLM dibangun di atas arsitektur jaringan saraf bernama transformer, yang diperkenalkan pada 2017 (IBM).
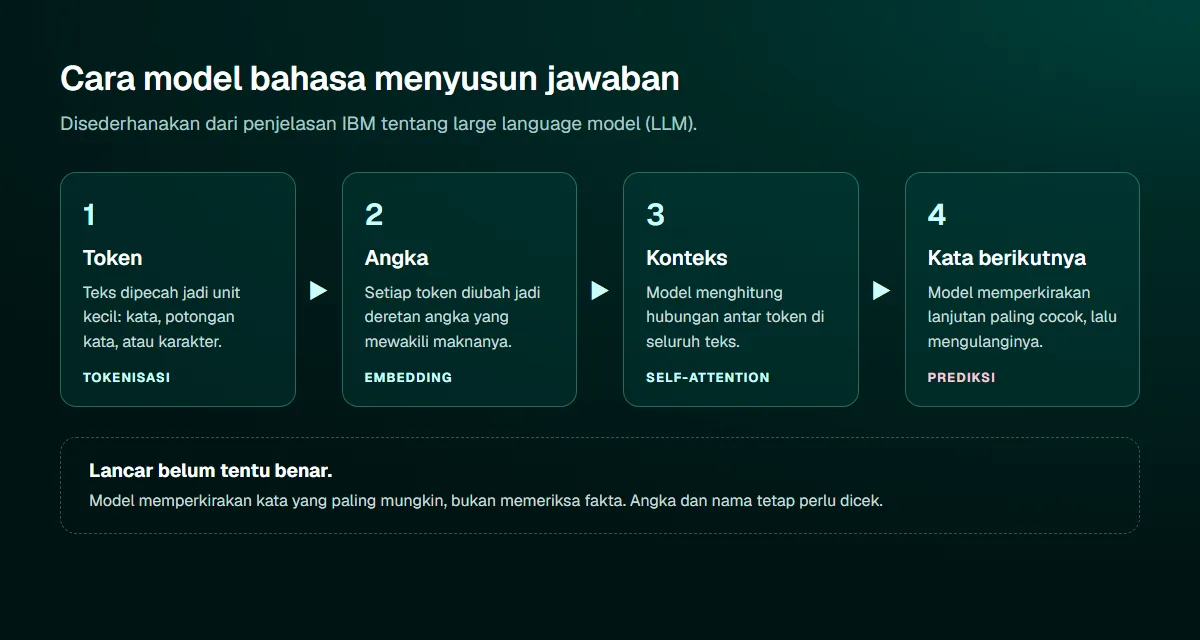
Model bahasa menyusun jawaban kata demi kata dengan memperkirakan lanjutan yang paling cocok. Diagram: Nalurika
Langkah dari penjelasan IBM tentang LLM, disederhanakan.
Langkah
Yang terjadi
Artinya untuk Anda
Tokenisasi
Teks dipecah menjadi unit kecil bernama token: kata, potongan kata, atau karakter
Panjang percakapan dihitung dalam token, bukan halaman
Embedding
Setiap token diubah menjadi deretan angka yang mewakili maknanya
Model bekerja dengan angka, bukan memahami seperti manusia
Self-attention
Model menghitung hubungan antar token, termasuk yang letaknya berjauhan
Konteks yang jelas di prompt membuat jawaban lebih tepat
Prediksi berulang
Model memperkirakan kata berikutnya, lalu mengulanginya sampai jawaban selesai
Jawaban yang lancar belum tentu benar
IBM menggambarkan LLM sebagai mesin prediksi statistik raksasa yang berulang kali memperkirakan kata berikutnya dalam sebuah urutan. Penjelasan lebih lengkap tentang AI yang menghasilkan konten ada di artikel generative AI adalah, dan cara menulis instruksi supaya hasilnya konsisten ada di artikel prompt engineering.
Kenapa AI bisa keliru, dan kenapa itu penting
Karena AI bekerja dari pola, ia bisa menghasilkan jawaban yang terdengar meyakinkan tetapi salah. Ada beberapa sebab yang perlu dipahami tim:
Data pelatihan berat sebelah. Google Cloud menulis bahwa AI hanya sebaik data yang dipakai untuk melatihnya; kalau datanya mencerminkan bias manusia, AI akan mempelajari dan meneruskan bias itu.
Data pelatihan kurang atau usang. Topik yang jarang dibahas, atau informasi yang berubah setelah pelatihan, rawan dijawab keliru.
Instruksi ambigu. Model mengisi kekosongan dengan tebakan paling mungkin, bukan bertanya balik, kecuali Anda memintanya.
Tidak ada pengecekan fakta bawaan. Prediksi kata berikutnya tidak sama dengan memeriksa sumber.
Apa artinya untuk tim yang mulai memakai AI
Memahami cara kerja AI membantu tim memakainya dengan ekspektasi yang tepat. Beberapa kebiasaan yang kami sarankan:
Beri konteks dan data. Makin jelas siapa pembacanya, tujuannya, dan bahan yang boleh dipakai, makin baik hasilnya. Contoh prompt yang bisa langsung dipakai ada di kumpulan prompt ChatGPT.
Pakai AI untuk draf, manusia untuk keputusan. Merangkum rapat, menyusun draf balasan, atau mengelompokkan chat cocok dibantu AI. Contohnya ada di artikel AI untuk notulen rapat.
Periksa sebelum mengirim. Tetapkan siapa yang mengecek hasil AI dan apa saja yang wajib dicek.
Mulai dari tugas berulang. Tugas yang polanya sering muncul, seperti menjawab pertanyaan umum pelanggan, paling cepat terasa manfaatnya. Pola ini dipakai di customer service AI dan chatbot WhatsApp.
Gabungkan dengan otomasi bila perlu. AI memahami bahasa, otomasi menjalankan langkah. Keduanya dijelaskan di artikel otomasi adalah dan apa itu agentic AI.
Kalau Anda ingin tim memahami dan memakai AI dengan benar dalam pekerjaan sehari-hari, lihat kursus AI untuk pemilik usaha dan tim dari Nalurika. Kalau yang Anda butuhkan adalah sistem yang langsung jalan, misalnya chat WhatsApp yang tercatat ke CRM, ada jasa AI untuk bisnis.
AI belajar dari banyak contoh data untuk mengenali pola, lalu memakai pola itu untuk membuat prediksi atau keputusan pada data baru. Proses belajarnya disebut pelatihan, dan proses memakai model yang sudah terlatih disebut inferensi.
Machine learning adalah bagian dari AI. IBM menyebut semua machine learning adalah AI, tetapi tidak semua AI adalah machine learning. Ada juga AI berbasis aturan yang logikanya ditulis manual, sedangkan machine learning mempelajari logikanya dari data.
ChatGPT memakai model bahasa besar. Menurut IBM, model seperti ini memecah teks menjadi token, mempelajari pola dari miliaran kata saat pelatihan, lalu saat dipakai berulang kali memperkirakan kata berikutnya yang paling cocok sampai jawabannya utuh.
Karena AI menghasilkan jawaban dari pola, bukan dari pengecekan fakta. Data pelatihan yang kurang, berat sebelah, atau sudah usang membuat hasilnya keliru. Google Cloud mengingatkan bahwa AI hanya sebaik data yang dipakai untuk melatihnya.
Tidak perlu sampai matematikanya. Cukup paham bahwa AI bekerja dari pola data, bisa keliru dengan yakin, dan sangat dipengaruhi instruksi serta data yang Anda berikan. Pemahaman ini membantu tim tahu kapan hasil AI perlu dicek.
Ceritakan pekerjaan tim Anda sehari-hari. Kami bantu menunjukkan bagian mana yang cocok dibantu AI, dan bagaimana tim bisa memeriksa hasilnya. Kami membalas di jam kerja.